メインコンテンツまでスキップ

【2026年7月】生成 AI モデルを比較 (Claude, GPT, Gemini, Grok, DeepSeek, Kimi, GLM, Mistral)

OpenRouter は、Claude、GPT、Gemini といったクローズドなモデルや中国発の オープンウェイトモデルまで、いろんなAIを切り替えて使える。とはいえ「結局どれを選べばいいのか」 と悩みがちなので、今回は主要モデルの値段と実力をざっくり比較してみた。

そもそも「オープン」と「クローズド」とは

  • クローズド: Claude・GPT・Gemini・Grok のように、モデルの中身(重み)が公開されていないもの。 会社のサーバー経由でしか使えない。
  • オープンウェイト: DeepSeek・Kimi・GLM・Mistral のように、モデルの中身が公開されていて、 誰でも自分のPCやクラウドで動かせるもの。

階級別の値段

まずは最重量の値段から。
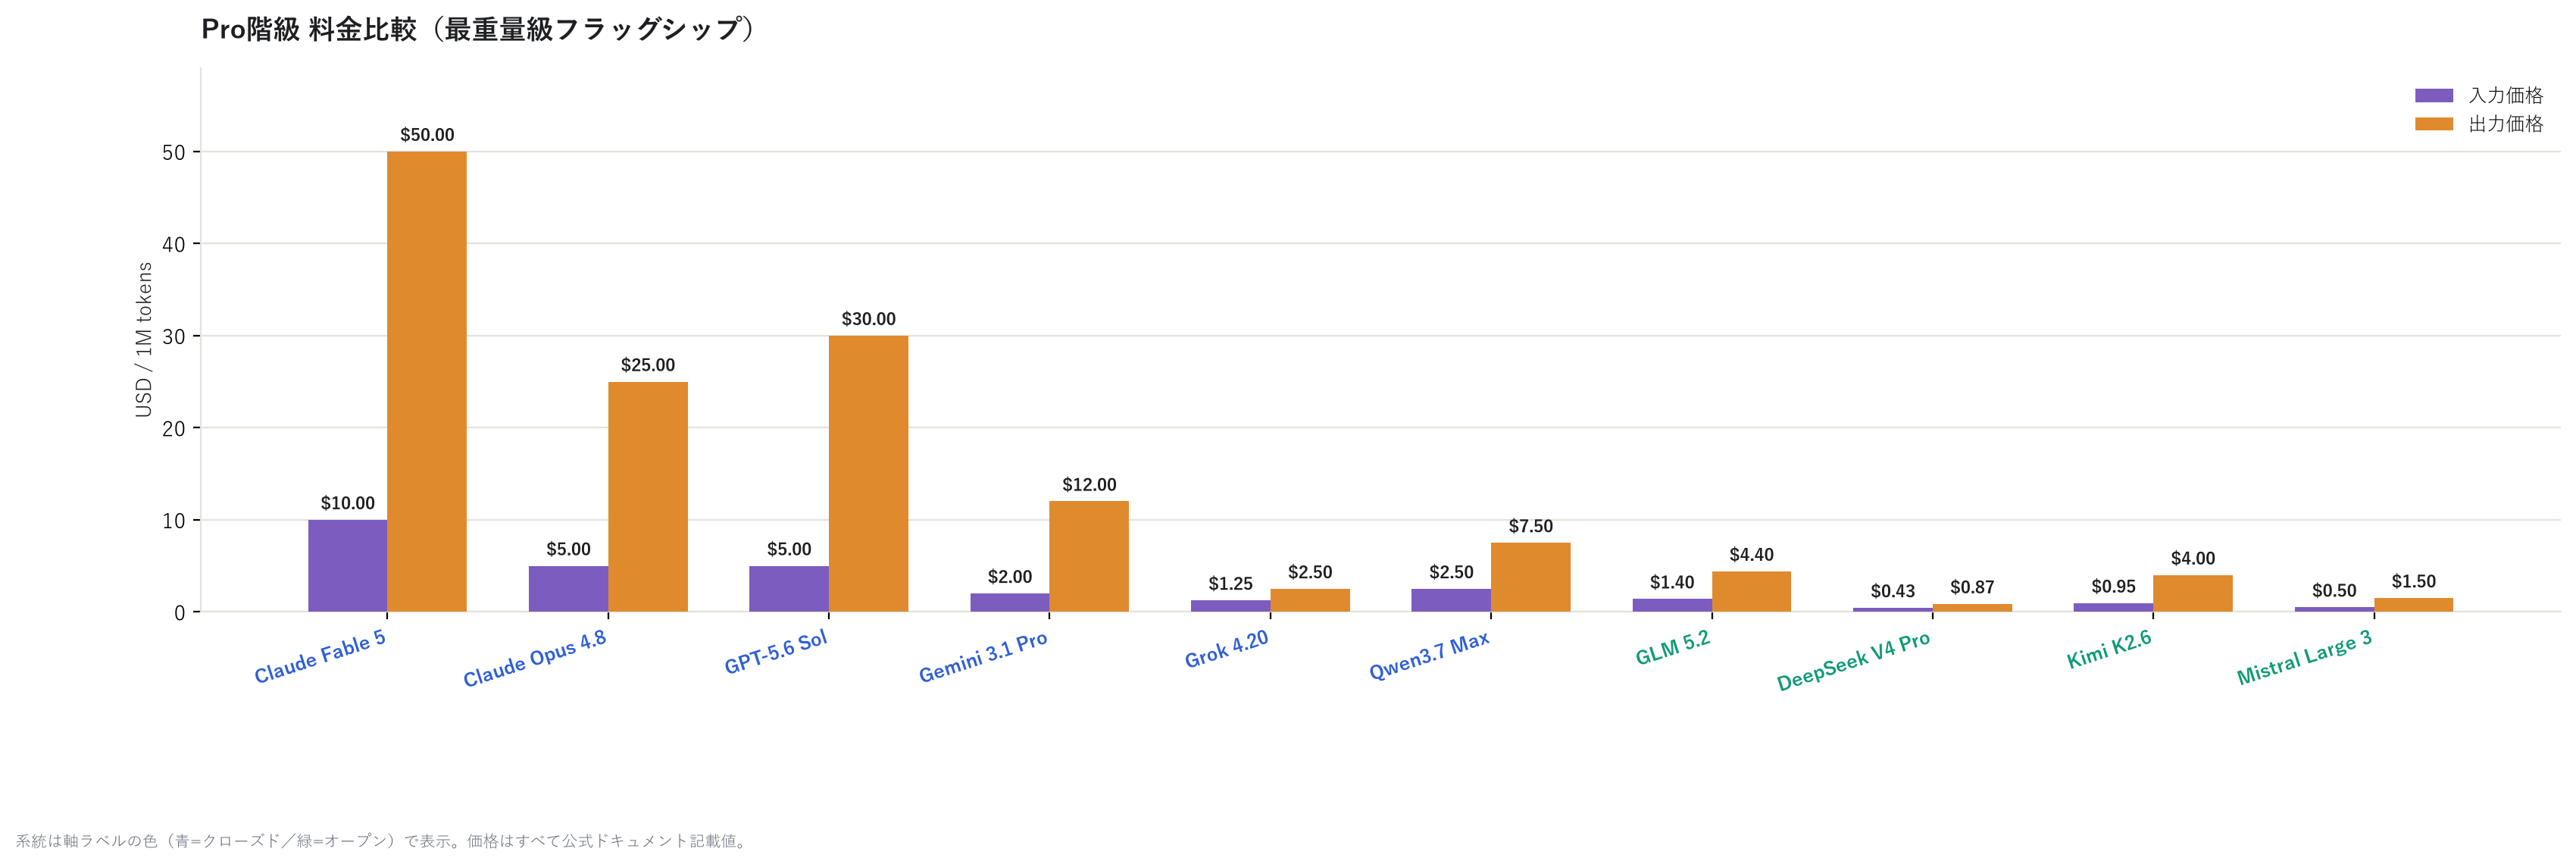
Pro階級 料金比較

見ての通り、Claude Fable 5 が圧倒的に高い(出力 $50/1Mトークン)一方、DeepSeek V4 Pro は 出力たったの $0.87。同じ「Pro」を名乗っていても、値段の差は50倍以上ある。オープン勢 (緑色のラベル)が軒並み安いのが一目瞭然だ。

中小量級も見てみる。
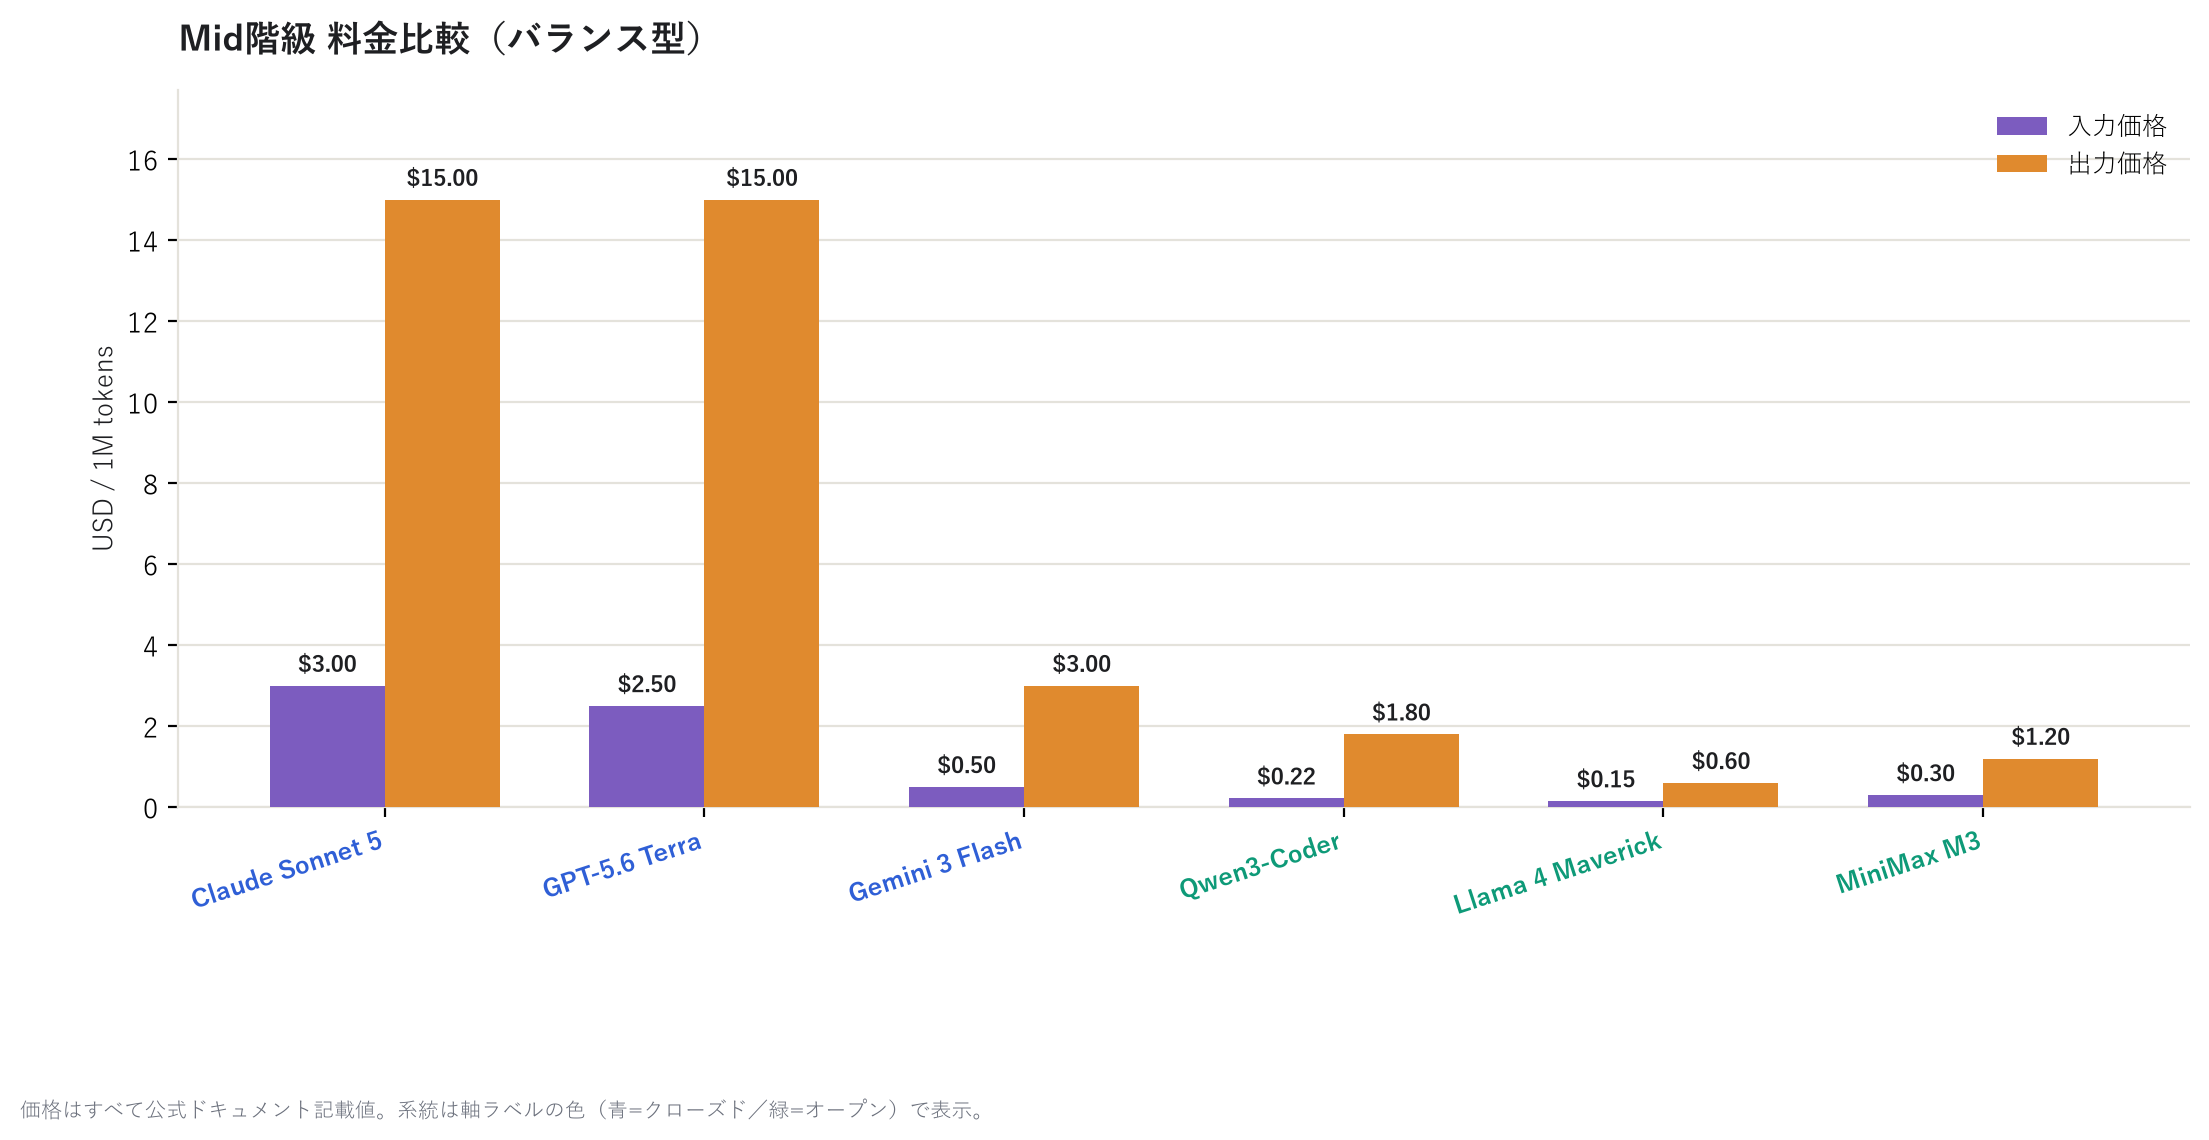
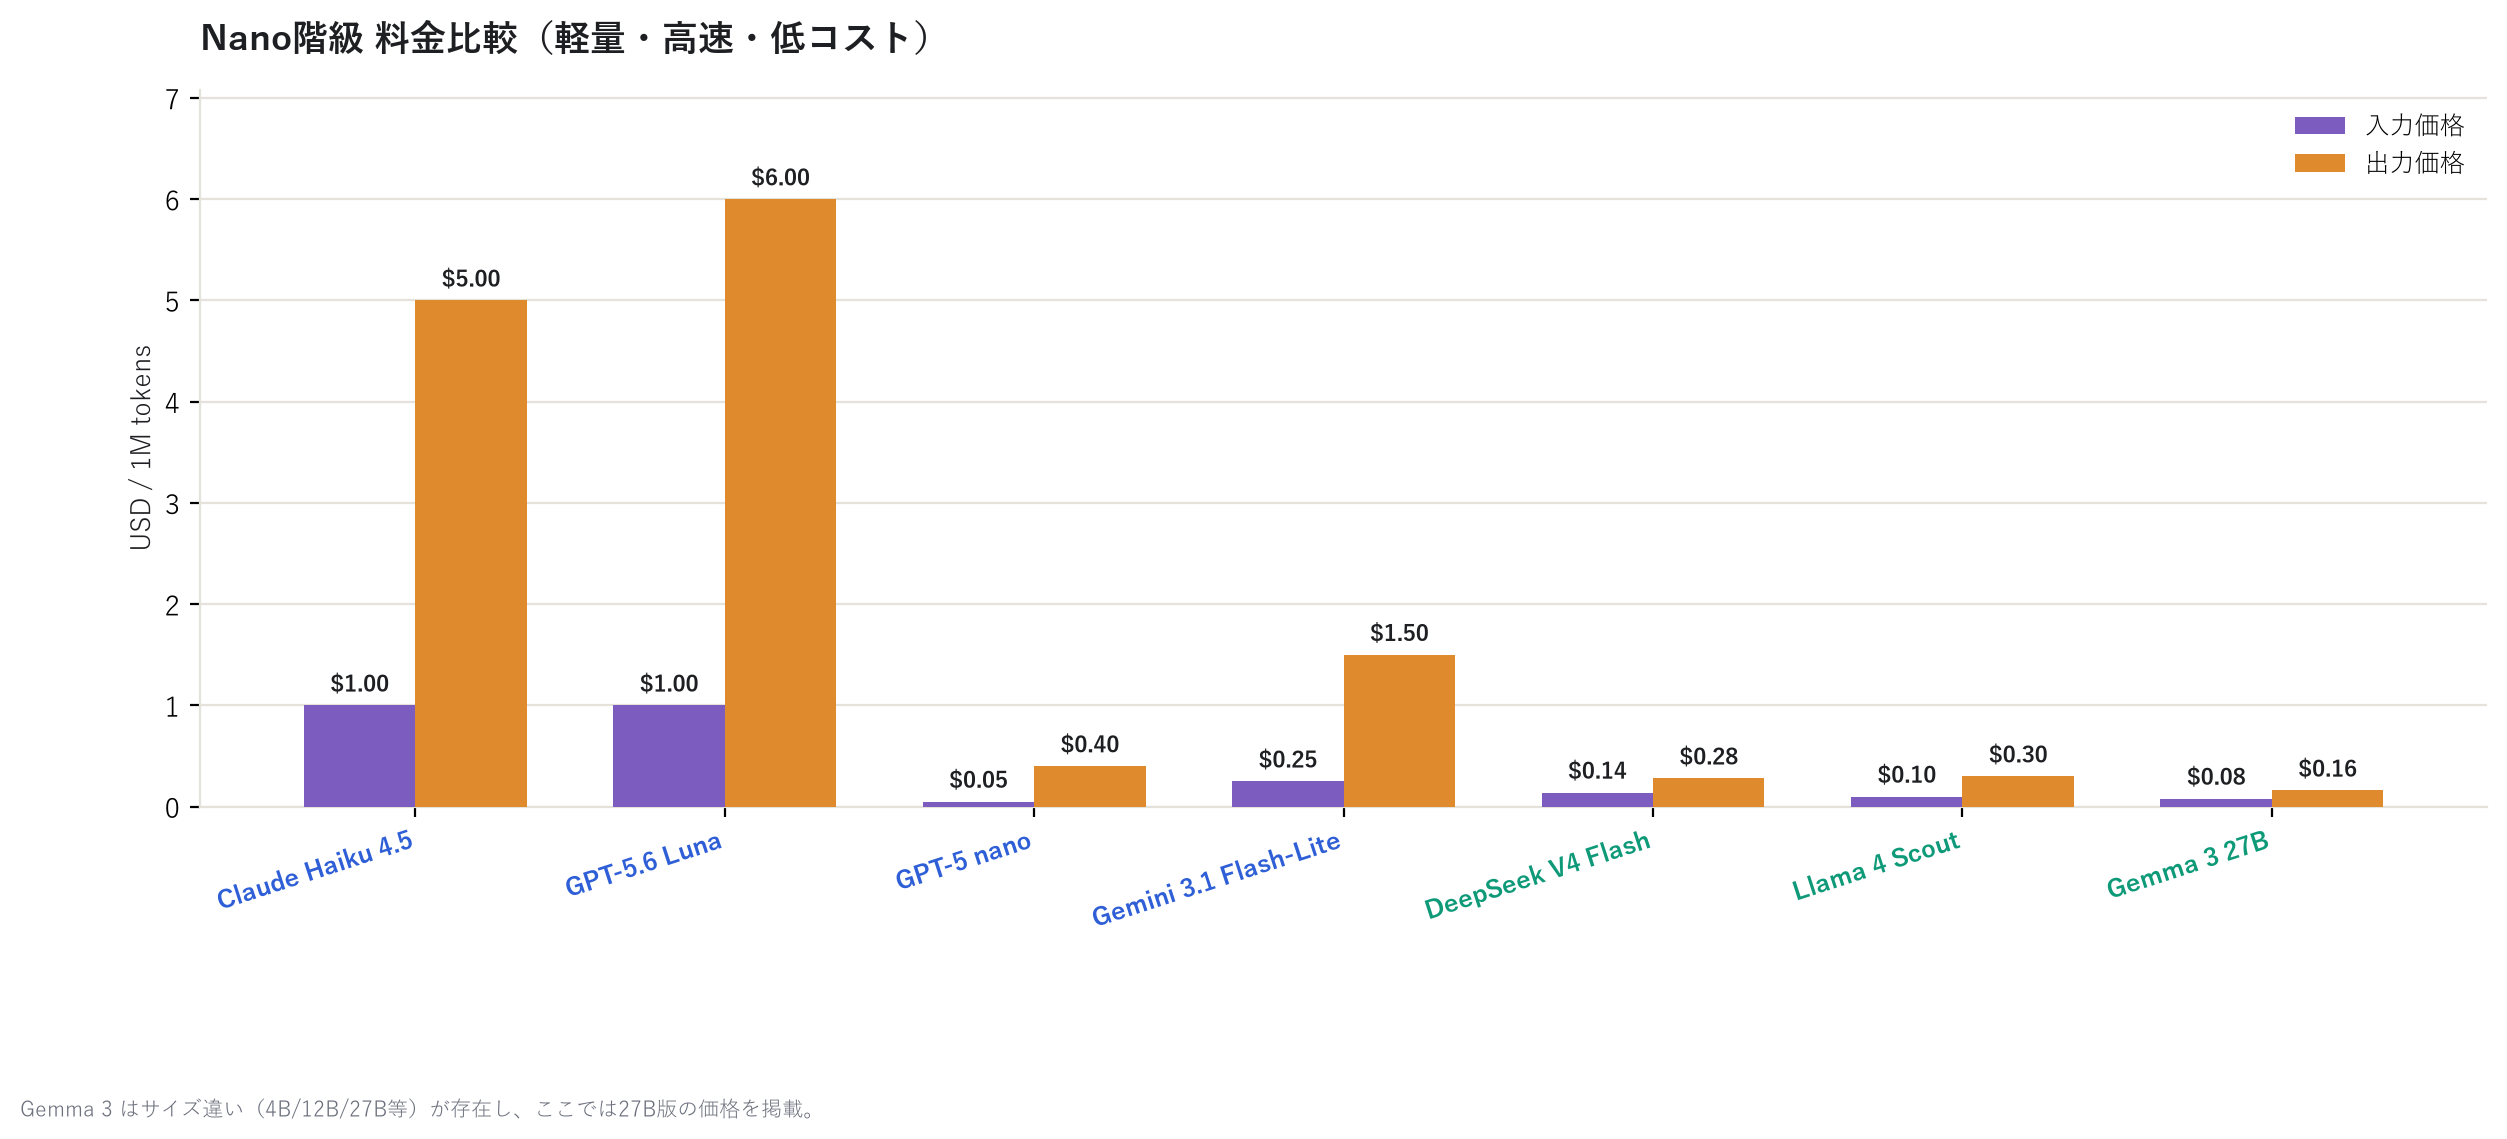
Mid階級 料金比較 Nano階級 料金比較

小量級になると、GPT-5 nano は出力 $0.40 とほぼ「使い放題」レベルの安さだ。ちょっとした 分類作業や下書き生成なら、この階級で十分なことも多い。

コスパを見てみる

値段だけ見ると「安いモデルは性能も低いのでは」と思いがちだが、実はそうでもない。 階級を分けずに、価格とIntelligence Indexのスコアがそろっているモデル20個を1枚にまとめてみる。 GPT・Gemini・Qwen・Llama・Gemma・Mistralなど、オープン/クローズド問わずできるだけ多くの モデルを含めた。
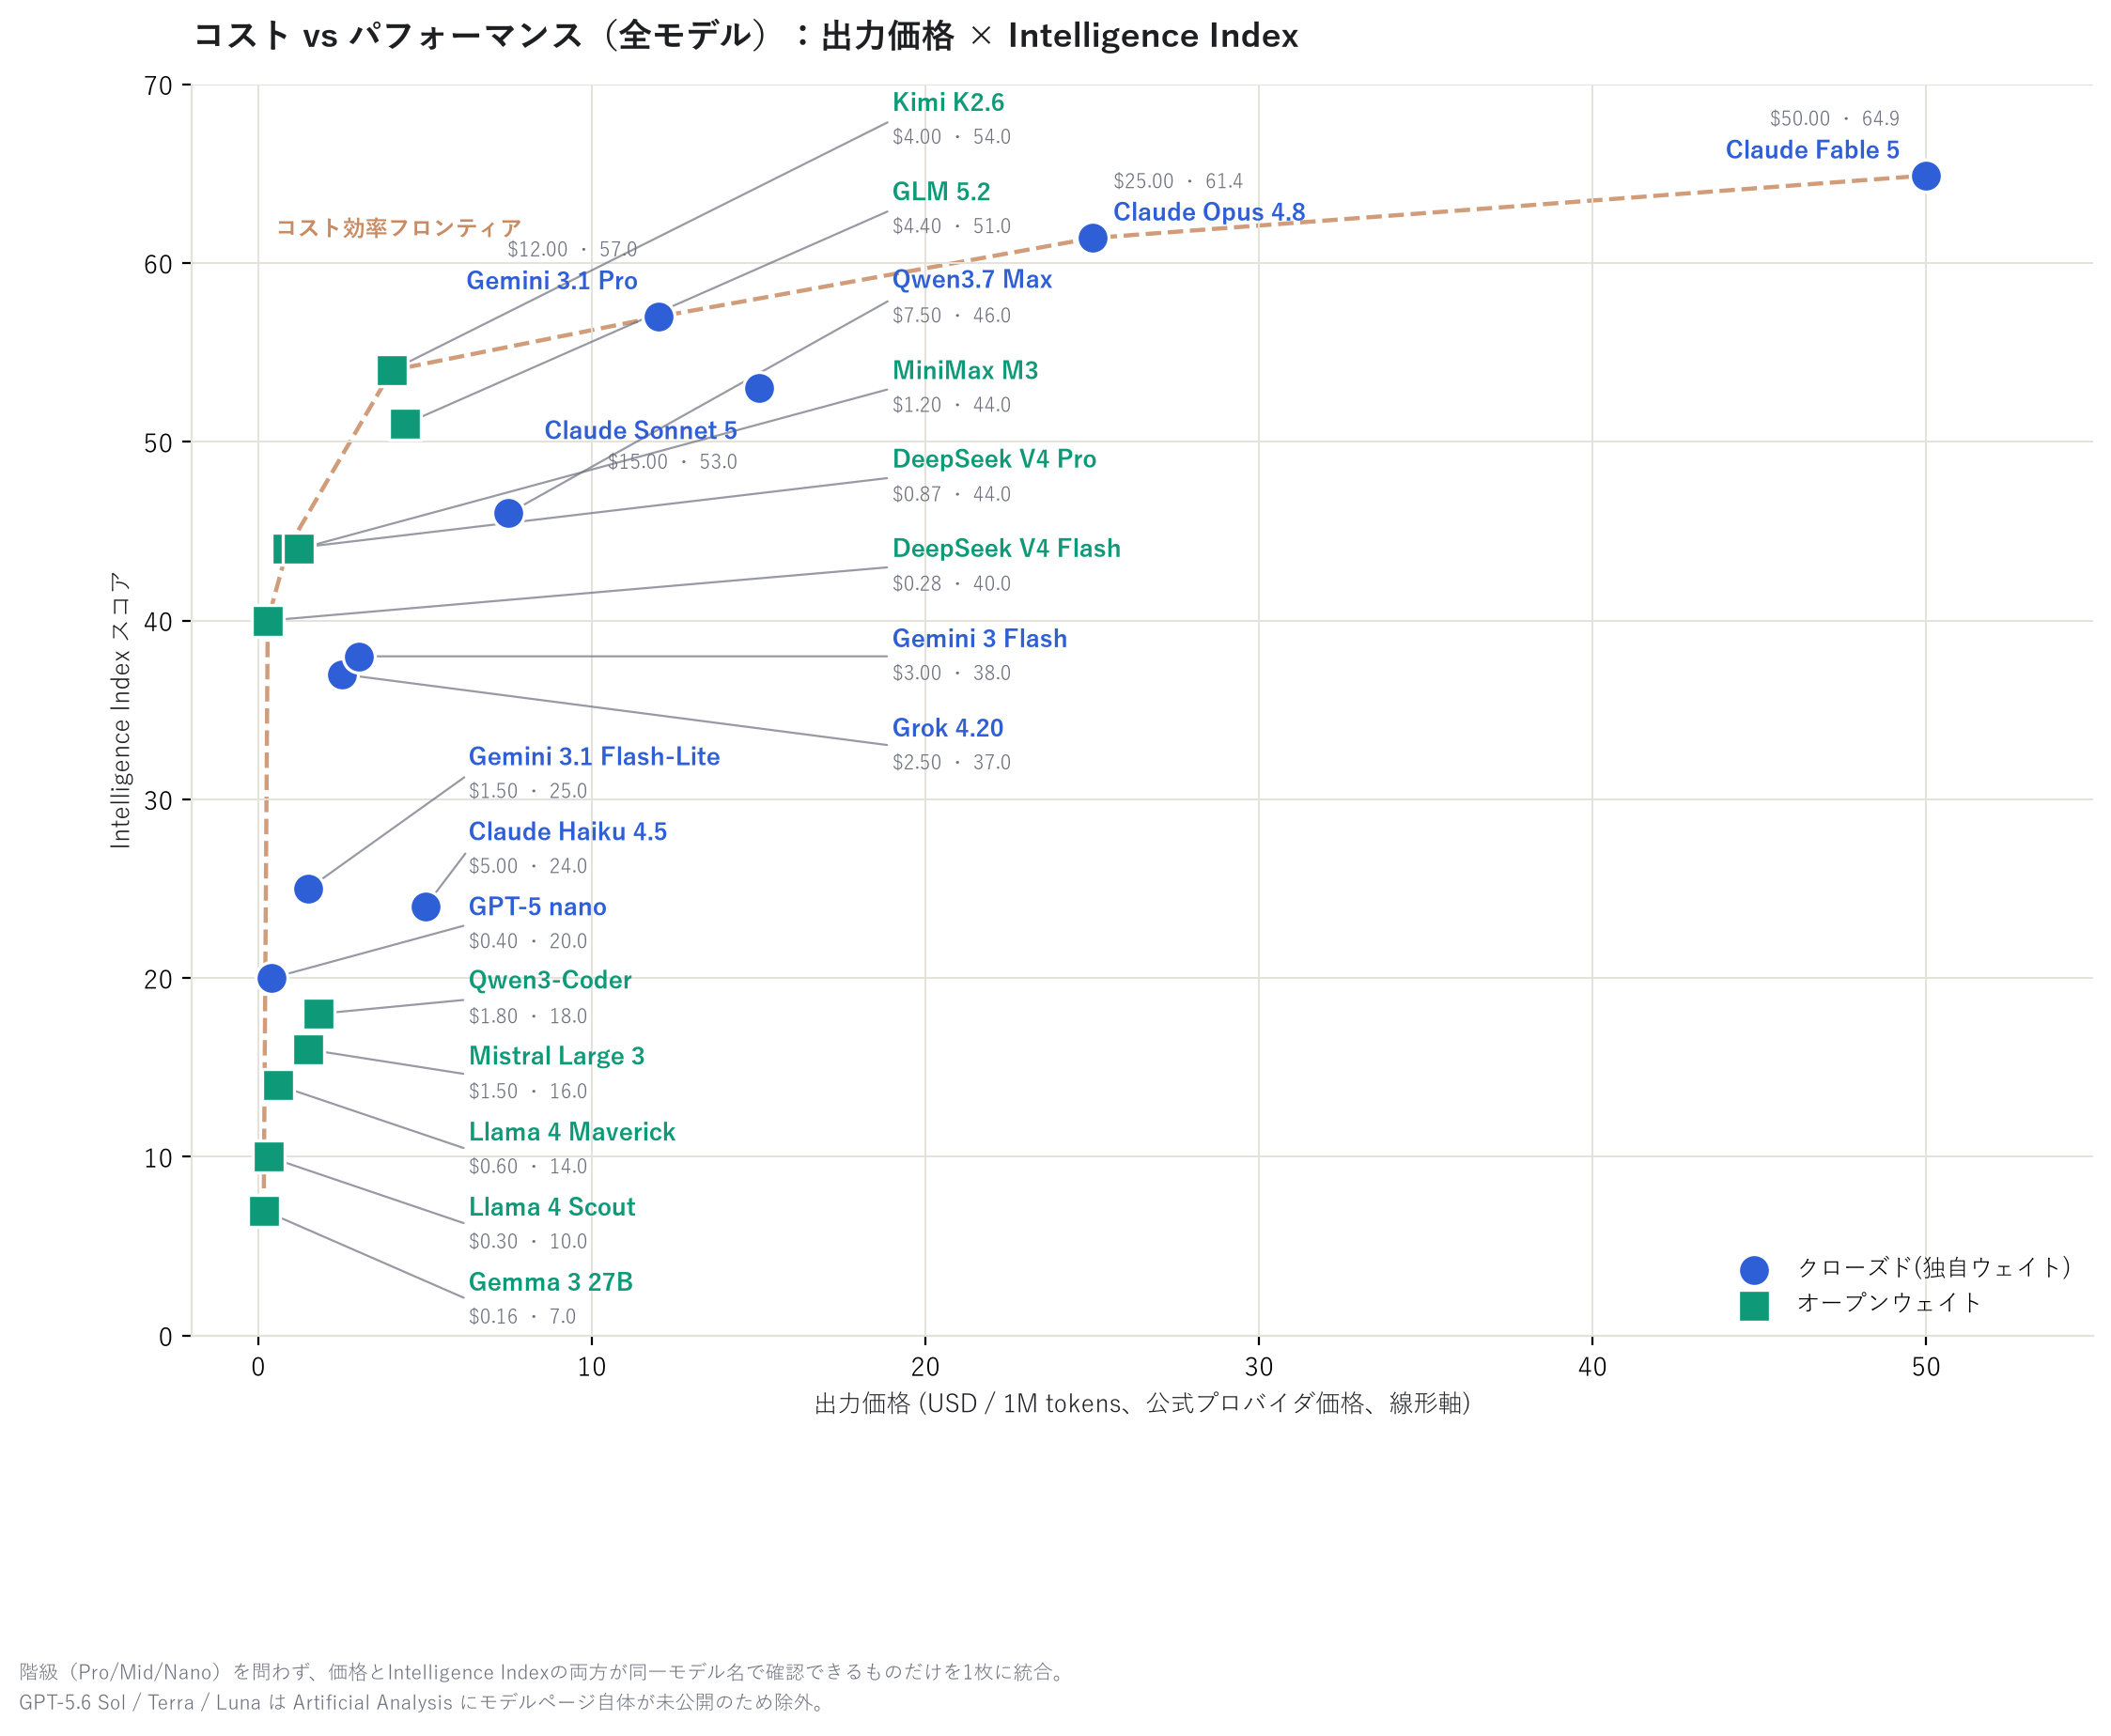
コスト vs パフォーマンス散布図(全モデル)

縦軸は「Intelligence Index」という総合力スコア(詳しくは後述)。点線で結んだ「コスパの良い ライン」は Gemma 3 27B → DeepSeek V4 Flash → DeepSeek V4 Pro → Kimi K2.6 → Gemini 3.1 Pro → Claude Opus 4.8 → Claude Fable 5 という、Nano・Mid・Proの階級をまたいだ 7モデルで形成されている。DeepSeek V4 Pro はわずか出力$0.87でGemini 3.1 Pro($12.00)に迫る スコアを出しており、実質的なコスパの起点として頭ひとつ抜けている。一方、フロンティアの内側に ある Qwen3.7 Max・MiniMax M3・GLM 5.2・Claude Sonnet 5・Gemini 3 Flash・Grok 4.20・ Claude Haiku 4.5・Gemini 3.1 Flash-Lite・Qwen3-Coder・Mistral Large 3・Llama 4 Maverick・ Llama 4 Scout などは「同じくらいの価格帯の他モデルより実力で見劣りする」ポジションだ。

コスパ重視なら、まずは一番安いところから試してみるのもアリだろう。

結局どのモデルが一番賢いのか

総合力とコーディング力のランキングも見てみる。
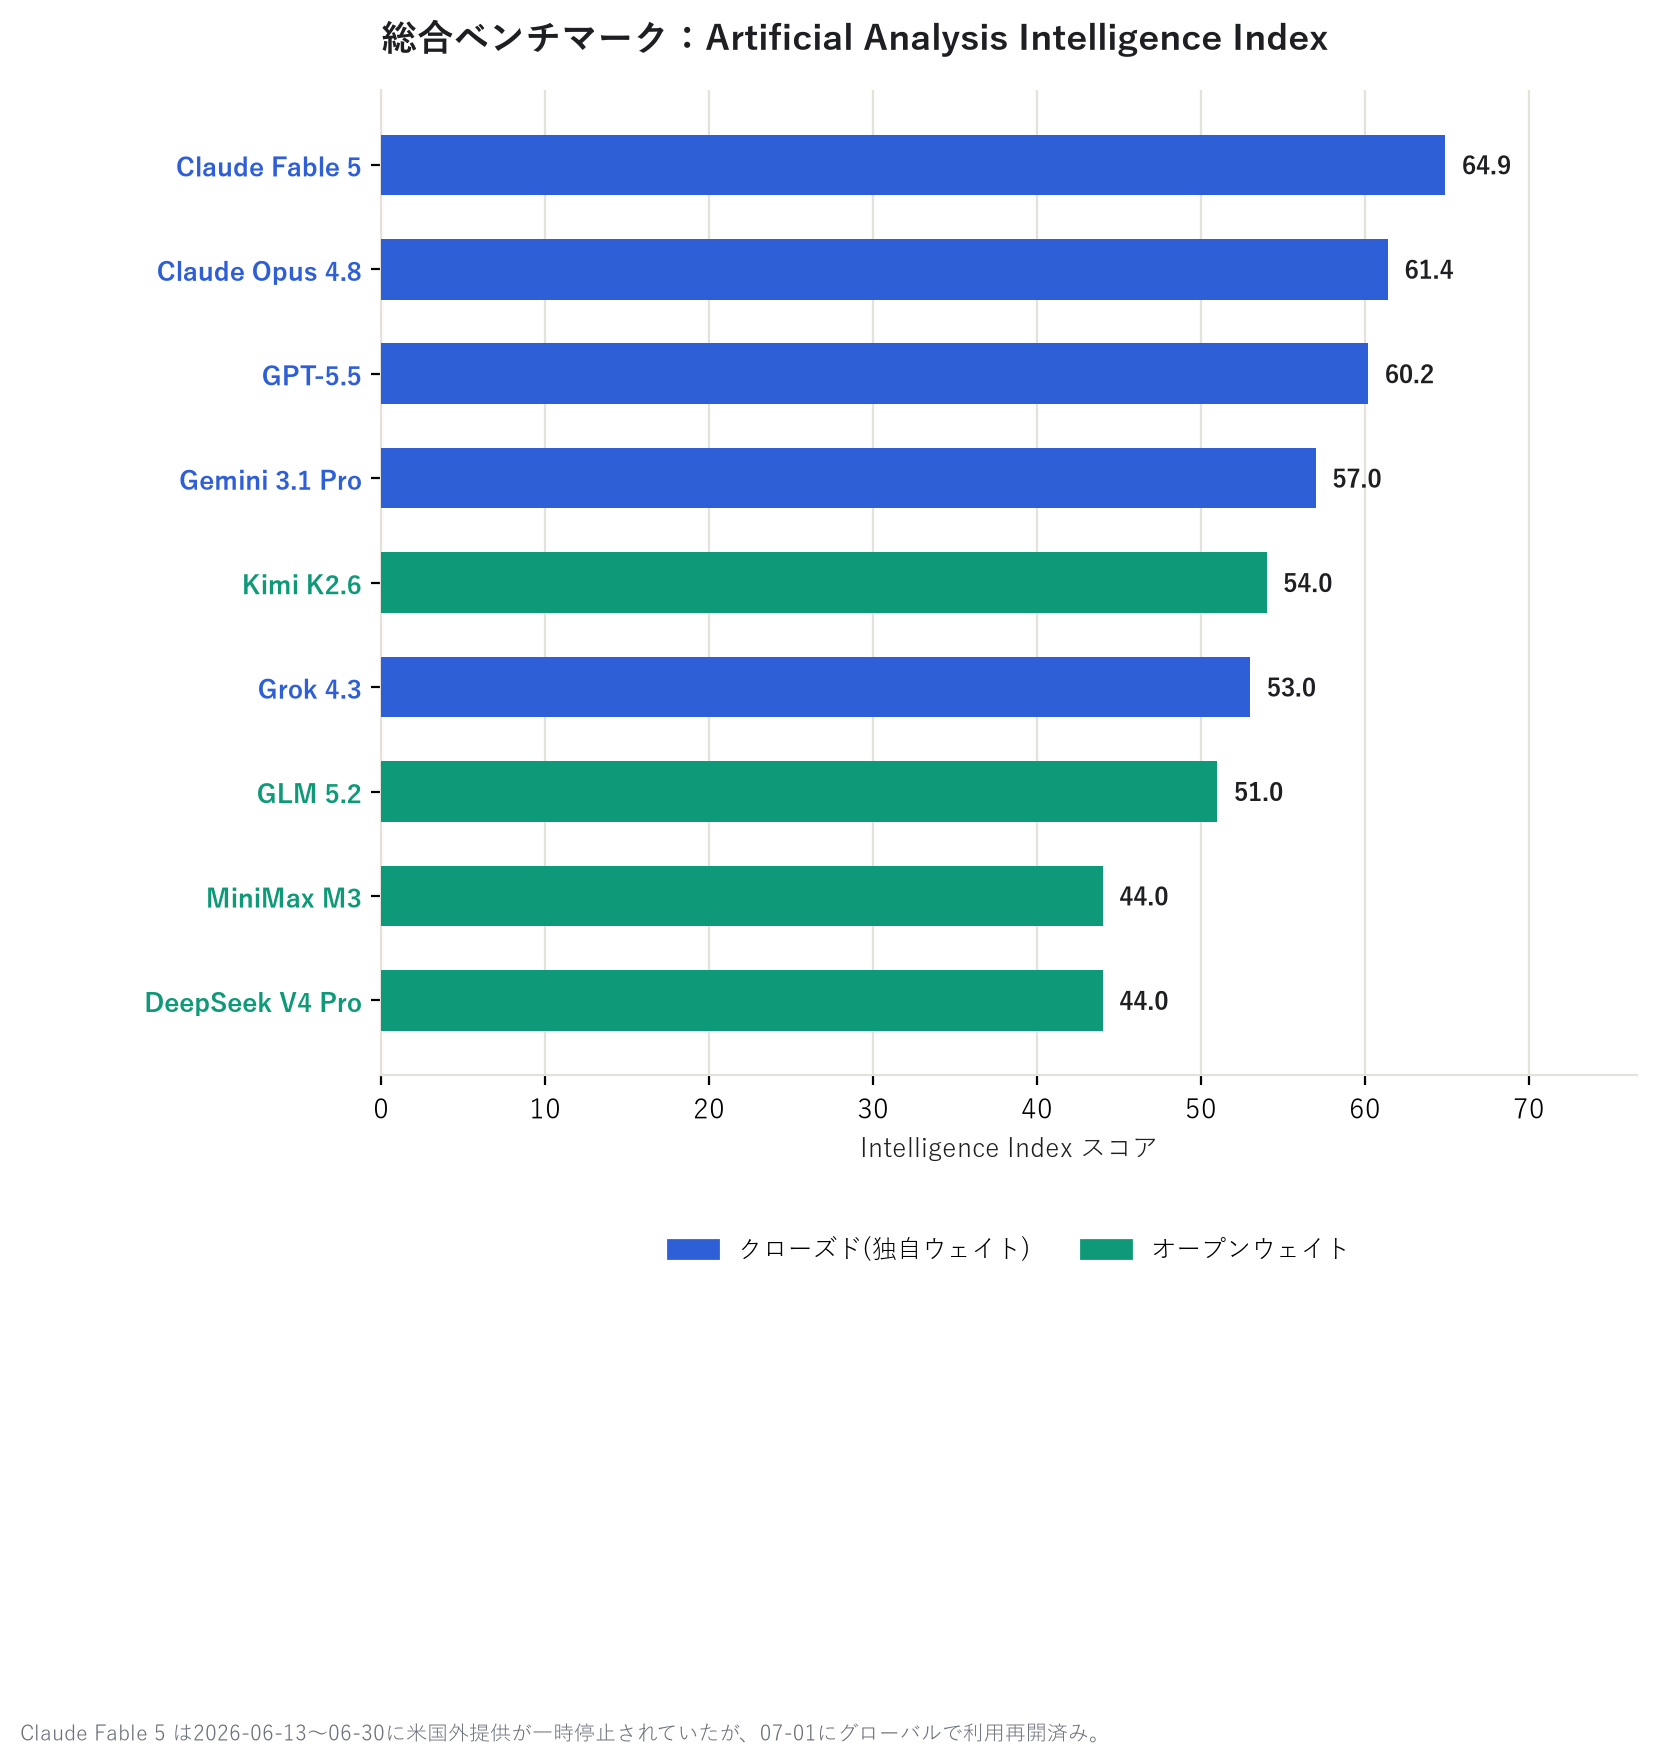
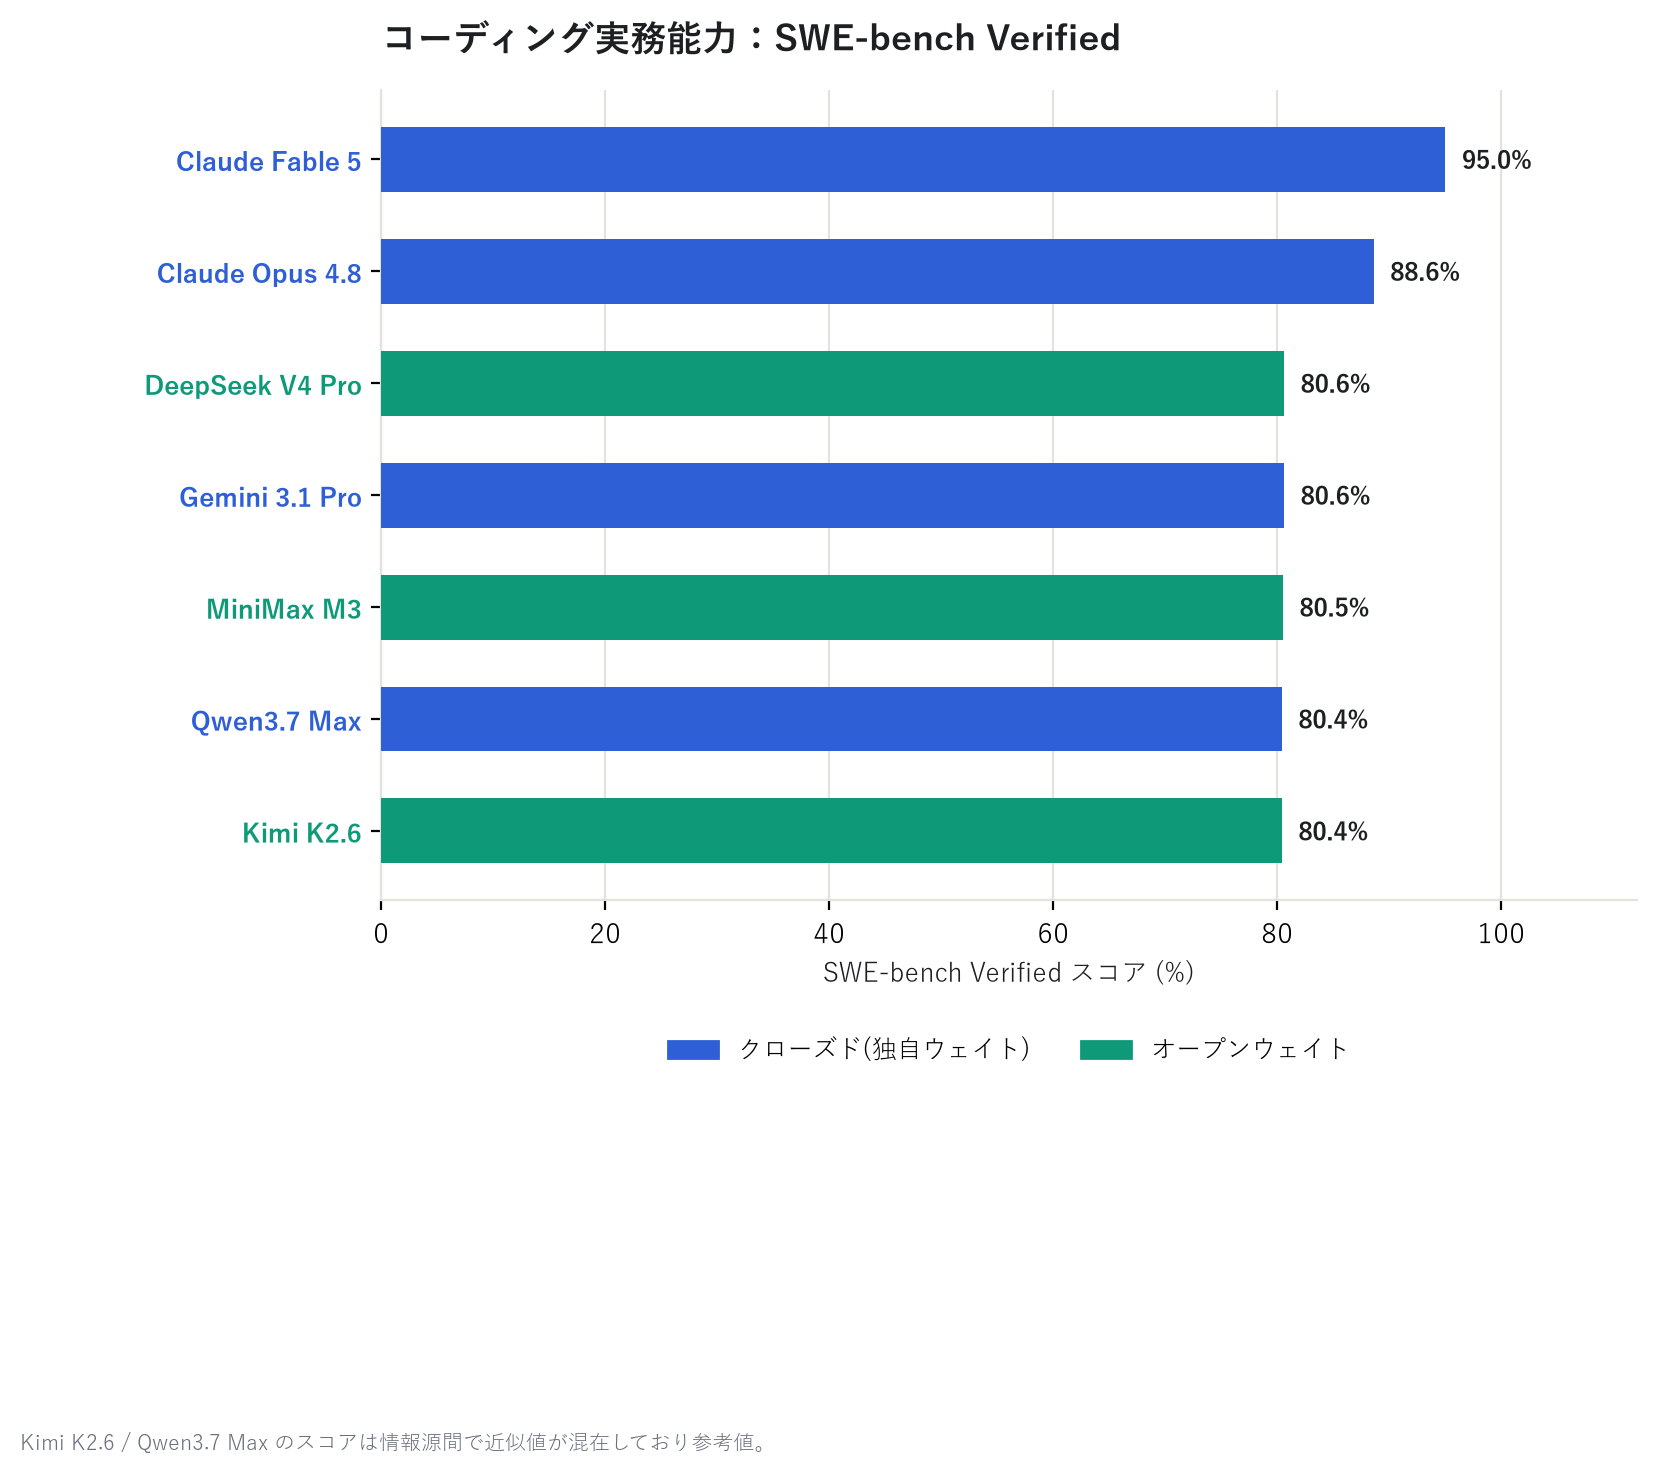
総合ベンチマーク:Artificial Analysis Intelligence Index コーディング実務能力:SWE-bench Verified

1枚目の「総合力」は Artificial Analysis Intelligence Index という第三者ベンチマーク団体の スコア、2枚目の「コーディング力」は SWE-bench Verified という、実在するソフトウェアの バグ修正課題をどれだけ解けるかを測るテストのスコアだ。どちらも各モデル会社の自己申告ではなく、 外部の評価サイトが計測・公表している数値である。

総合力では Claude Fable 5 がGPT-5.5に約5ポイント差をつけてトップ、僅差で Claude Opus 4.8・ GPT-5.5・Gemini 3.1 Pro が続く。コーディングに限っても Claude Fable 5 が頭ひとつ抜けて95% というスコアだ。そのすぐ下に、オープン系の DeepSeek V4 Pro がクローズド勢と肩を並べているのも 面白いポイントである。

おまけ:オープンモデルの「中身の大きさ」

オープンウェイトモデルは中身が公開されているので、パラメータ数(モデルの大きさ)も分かる。 バーの濃い緑が実際に推論で使われる「活性化パラメータ」、薄い緑がMoE(Mixture of Experts)構成上 その時使われていない残りのエキスパート分だ。
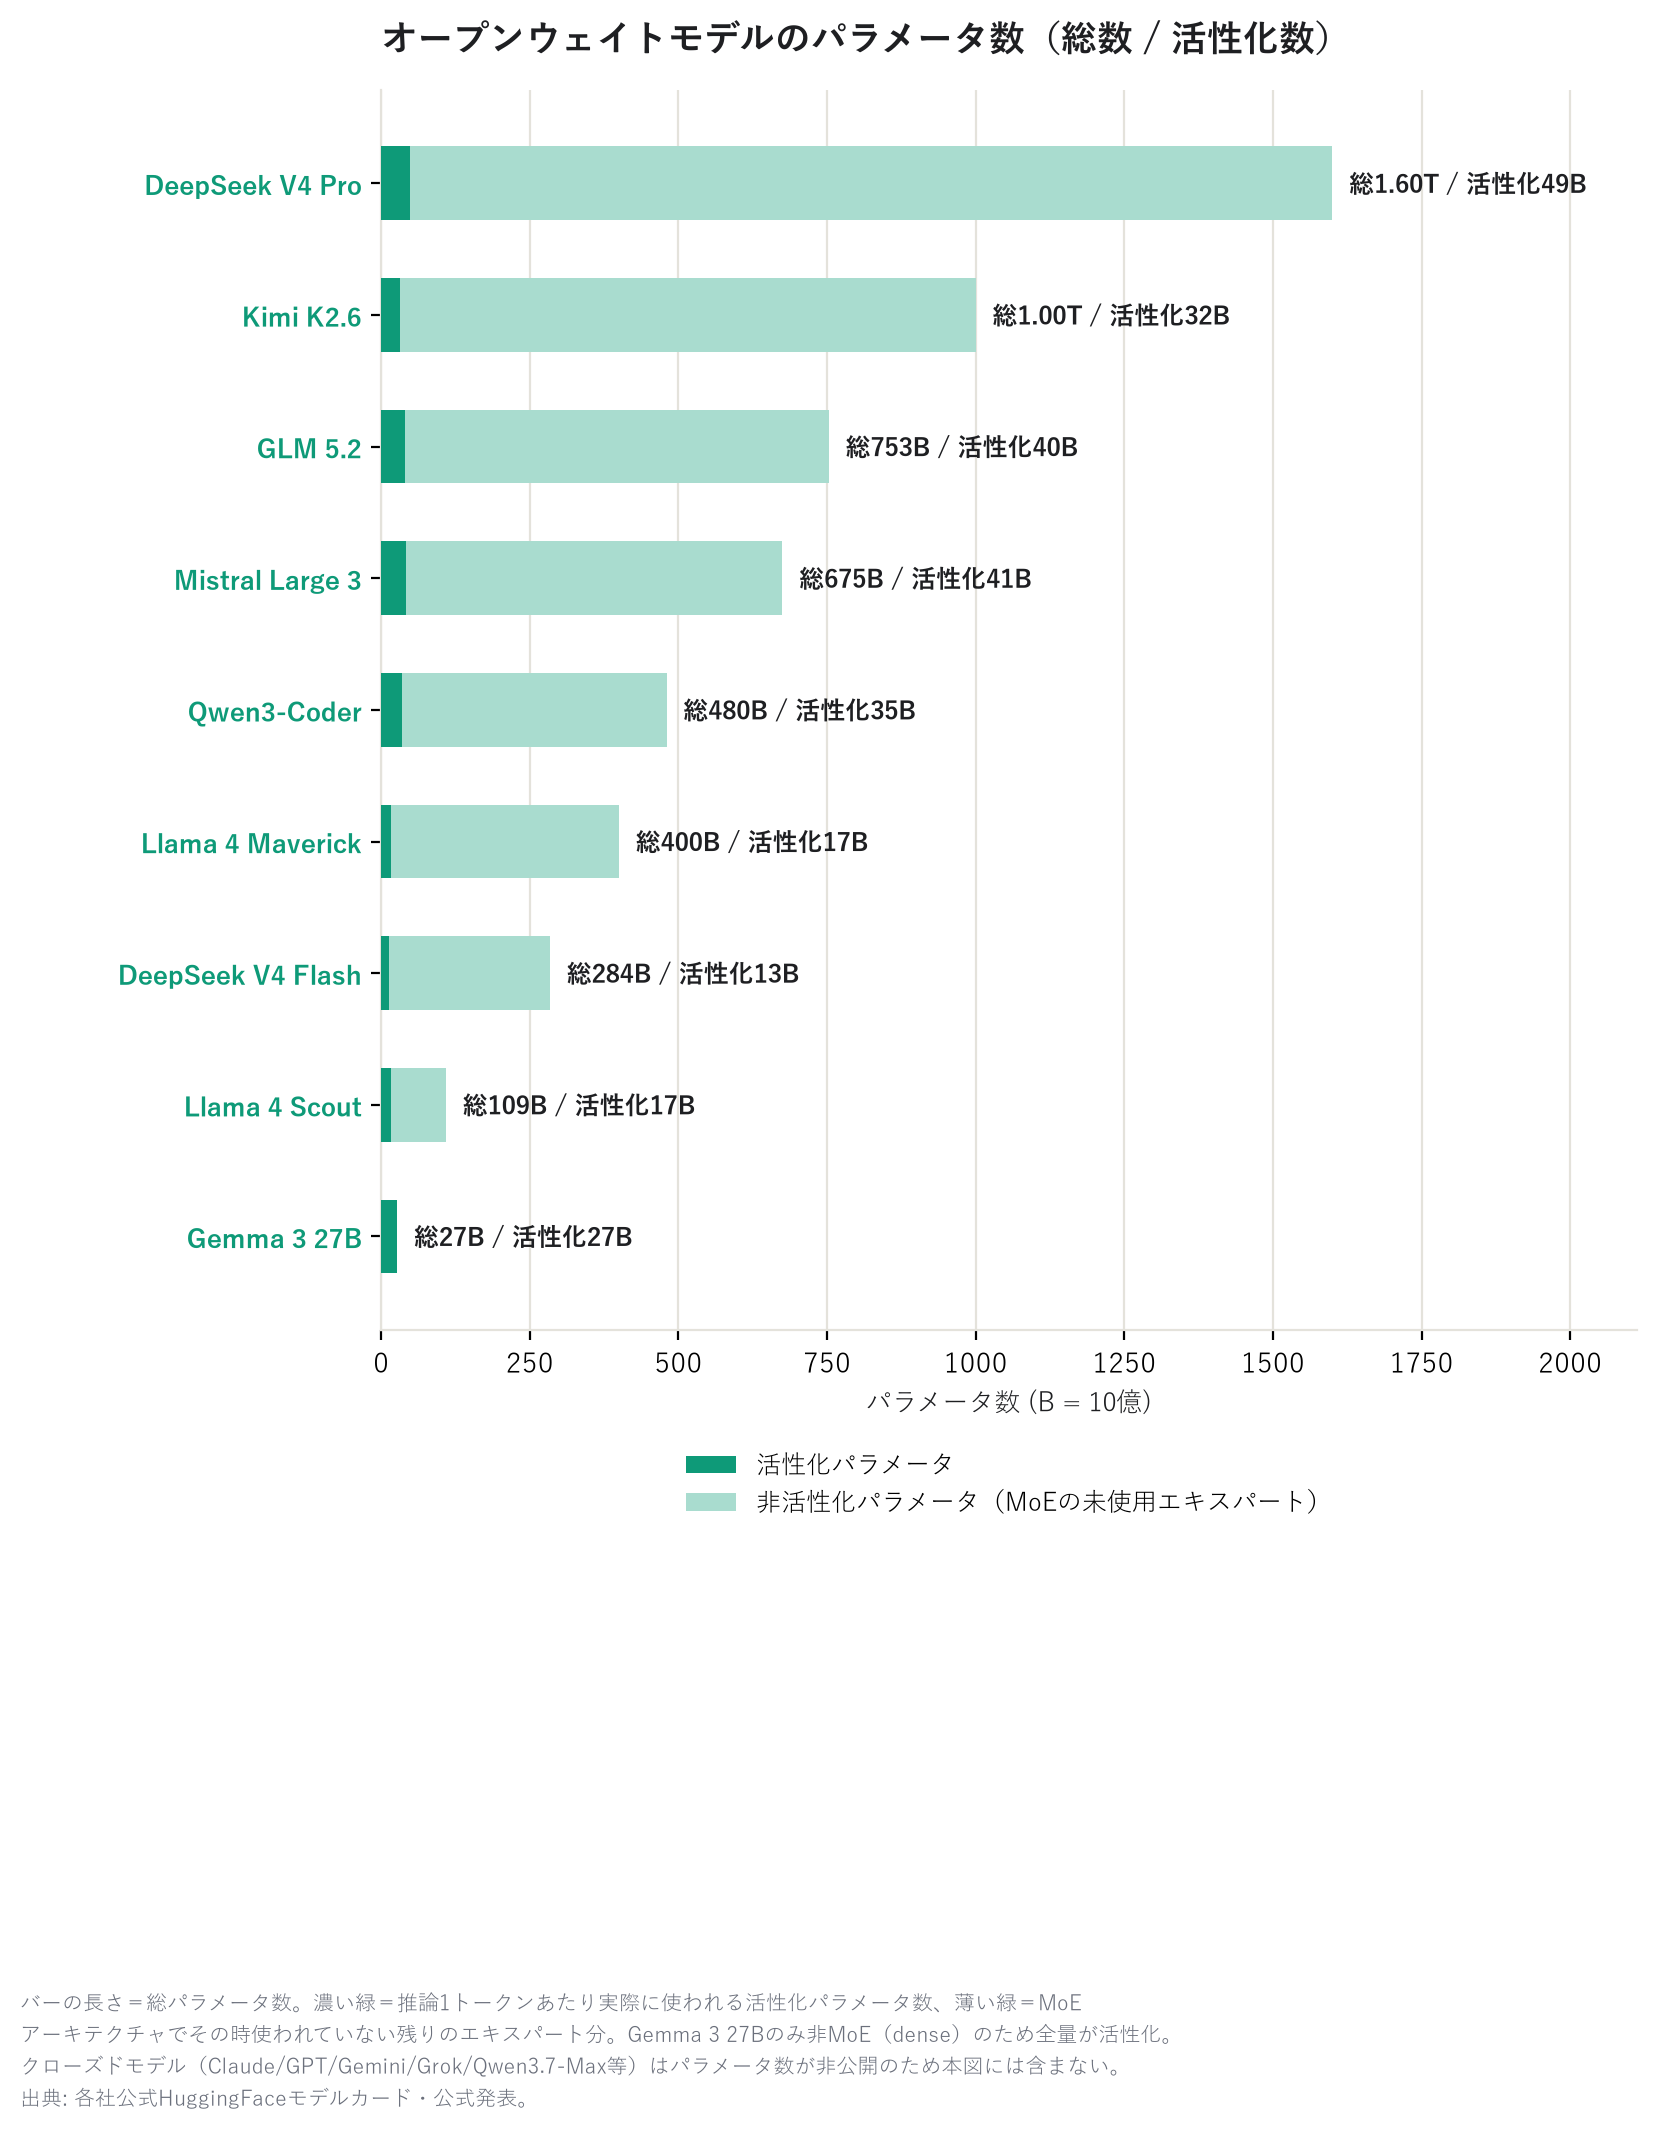
オープンウェイトモデルのパラメータ数

DeepSeek V4 Pro が総1.6兆パラメータで一番大きいが、実際に動くときに使うのは そのうち490億だけ(MoEという仕組みのおかげ)。大きい割に軽快に動く、というのがポイントだ。 図中で唯一 Gemma 3 27Bだけはバーが全部濃い緑になっているが、これはMoEではなく 全パラメータを毎回使う「dense」構成だから。デンスモデルは総数=活性化数になるため、 MoE勢とは大きさの比較の意味合いが少し異なる点に注意。

まとめ:どれを選べばいいか

  • とにかく一番賢いのが欲しい → Claude Fable 5 か Claude Opus 4.8(値段は覚悟)
  • コスパ重視、コーディングもさせたい → DeepSeek V4 Pro(激安なのにかなり優秀)
  • 普段使いのバランス型 → Claude Sonnet 5 や Gemini 3 Flash
  • とにかく安く大量にさばきたい → GPT-5 nano や DeepSeek V4 Flash

値段もランキングも動きが早い世界なので、実際に使う前には openrouter.ai/models で最新情報を確認することを忘れずに。

スコアの情報元

本記事で使ったベンチマークスコアの出典は以下の通り。いずれもモデル提供元とは独立した 第三者の評価サイトが計測・公表している数値である。

なお Kimi K2.6 / Qwen3.7 Max の SWE-bench Verified スコアは、情報源間で近似値が混在しており 参考値として扱っている。

GLM-5.2 / GLM-4.7-Flash モデルを Claude Code で使用するには

Claude Code CLI (claude) は、Anthropic 純正のモデルだけでなく、OpenRouter が提供する Anthropic Messages API 互換エンドポイント("Anthropic Skin")を使うことで、任意のモデルを バックエンドとして動かせる。今回は会話のメインモデルに z-ai/glm-5.2、タイトル生成などの 軽量な背景タスク用に z-ai/glm-4.7-flash を割り当てる設定を試したので、そのやり方をまとめる。

参考: https://openrouter.ai/docs/cookbook/coding-agents/claude-code-integration

前提条件

  • $env:OPENROUTER_API_KEY に OpenRouter の API キーが設定済みであること。
  • Claude Code に claude.ai アカウントでログイン済みでも、環境変数による認証があればそちらが 優先される。その際 ⚠ claude.ai connectors are disabled ... という警告が出るが、動作には 影響しない。

必要な環境変数

変数備考
ANTHROPIC_BASE_URLhttps://openrouter.ai/apiOpenRouter の Anthropic 互換エンドポイント
ANTHROPIC_AUTH_TOKENOpenRouter の API キーAuthorization: Bearer として送られる
ANTHROPIC_API_KEY""(明示的に空文字)未設定/非空だと認証方式が競合してエラーになる
ANTHROPIC_MODELz-ai/glm-5.2メインの会話モデル。OpenRouter 上のモデル ID をそのまま指定する
ANTHROPIC_SMALL_FAST_MODELz-ai/glm-4.7-flashタイトル生成など軽量な背景タスク用のサブモデル

メイン/サブモデルの使い分け

ANTHROPIC_MODEL はメインの会話モデルのみを制御する。タイトル生成や auto-mode 判定など、 Claude Code が内部的に使う軽量・高速なサブモデルは ANTHROPIC_SMALL_FAST_MODEL で指定する。 この変数を設定しておけば、それだけで軽量タスク用のモデルを確実に切り替えられる。

セットアップ方法

方法A: プロジェクト単位で有効にする(推奨)

リポジトリの .claude/settings.local.json に以下を設定する。

{
"env": {
"ANTHROPIC_BASE_URL": "https://openrouter.ai/api",
"ANTHROPIC_API_KEY": "",
"ANTHROPIC_MODEL": "z-ai/glm-5.2",
"ANTHROPIC_SMALL_FAST_MODEL": "z-ai/glm-4.7-flash"
}
}

ANTHROPIC_AUTH_TOKEN(秘密情報)はファイルに書かず、シェル側で OPENROUTER_API_KEY から 供給する。PowerShell プロファイル($PROFILE)に以下を一度追加しておけば、以後シェルを開くたびに 自動で設定される。

$env:ANTHROPIC_AUTH_TOKEN = $env:OPENROUTER_API_KEY

bash/zsh の場合は ~/.bashrc~/.zshrc に:

export ANTHROPIC_AUTH_TOKEN="$OPENROUTER_API_KEY"

この状態でこのディレクトリ内で claude -p "..." を実行すると、.claude/settings.local.json の設定が自動的に読み込まれ、OpenRouter 経由でメイン/サブ両モデルが使われる。他のプロジェクトの Claude Code 実行には影響しない。

方法B: 特定のコマンドだけ一時的に切り替える

シェルプロファイルを変更したくない場合、その場で環境変数を指定して実行する。

PowerShell:

$env:ANTHROPIC_BASE_URL = "https://openrouter.ai/api"
$env:ANTHROPIC_AUTH_TOKEN = $env:OPENROUTER_API_KEY
$env:ANTHROPIC_API_KEY = ""
$env:ANTHROPIC_MODEL = "z-ai/glm-5.2"
$env:ANTHROPIC_SMALL_FAST_MODEL = "z-ai/glm-4.7-flash"
claude -p "1+1は?"

bash:

ANTHROPIC_BASE_URL="https://openrouter.ai/api" \
ANTHROPIC_AUTH_TOKEN="$OPENROUTER_API_KEY" \
ANTHROPIC_API_KEY="" \
ANTHROPIC_MODEL="z-ai/glm-5.2" \
ANTHROPIC_SMALL_FAST_MODEL="z-ai/glm-4.7-flash" \
claude -p "1+1は?"

方法C: マシン全体のデフォルトにする(非推奨)

上記の変数を Windows のユーザー環境変数として永続化すれば、どのターミナル・どのプロジェクトでも デフォルトで OpenRouter/GLM 経由になる。ただし他のプロジェクトで通常の Claude(Anthropic) を 使うつもりの操作にも影響してしまうため、意図せず全体のデフォルトを変えたくない場合は方法A/Bを推奨。

動作確認

以下のコマンドで応答および課金ログ (modelUsage) に z-ai/glm-5.2 が記録されることを確認した。

claude -p "Reply with exactly: OK-GLM-TEST" --output-format json
{
"result": "OK-GLM-TEST",
"modelUsage": {
"z-ai/glm-5.2": { "inputTokens": 3272, "outputTokens": 8, "costUSD": 0.028336 }
}
}

また、少し長めのプロンプトで --debug all を付けて実行すると、メインモデルとサブモデルへの ディスパッチが両方とも実際に発生することも確認できた。

[API:timing] dispatching to firstParty model=z-ai/glm-4.7-flash
[API:timing] dispatching to firstParty model=z-ai/glm-5.2

1 回のプロンプトに対し、軽量タスクは z-ai/glm-4.7-flash、本編の応答は z-ai/glm-5.2 と、 モデルが正しく使い分けられている。

既知の注意点: 対話型セッションでのリクエスト増殖

対話型の claude セッション(VS Code から開いた場合や TTY 上で直接起動した場合)では、軽く 入力しただけで OpenRouter の Activity ログ上に同一分内で 13 回もの API 呼び出しが記録された。 そのうち 12 回はサブモデル(GLM 4.7 Flash)宛ての小さな呼び出しで、最後の 1 回だけメインモデル (GLM 5.2)による本編の応答だった。合計コストは約 $0.0094 に収まっている。

一方、claude -p(非対話・print モード)による単発実行では、この増殖はほぼ発生しないことを 確認済み。コストを抑えたい用途では -p を使う方が安全。対話型セッションを常用する場合は、 ANTHROPIC_SMALL_FAST_MODEL を設定して安価なモデルにリクエストを流しつつ、OpenRouter の Activity ダッシュボードで消費を監視するとよい。

トラブルシューティング

  • ⚠ claude.ai connectors are disabled because ANTHROPIC_API_KEY or another auth source is set... という警告は無視してよい(claude.ai のコネクタ機能が無効になるだけで、API 呼び出し自体は成功する)。
  • ANTHROPIC_API_KEY を空文字ではなく未設定のままにすると認証方式が曖昧になりエラーになることがある。 必ず "" を明示的に設定すること。
  • 別モデルに切り替えたい場合は ANTHROPIC_MODEL を OpenRouter 上のモデル ID (例: anthropic/claude-opus-4-8, openai/gpt-5 など)に変更するだけでよい。
  • ツール検索の最適化(ENABLE_TOOL_SEARCH)は非 Anthropic ホストではデフォルト無効になる。 必要なら ENABLE_TOOL_SEARCH=true を追加する。

Claude Code も Codex も Gemini もつなぐ、LLM API 変換プロキシ「llmglot」を開発した

AI 開発の現場では、モデルそのものよりも API 仕様の違いに悩まされることが増えている。

Claude Code は Anthropic Messages API を利用する。OpenAI 系ツールは Chat Completions API や Responses API を利用する。Gemini は独自 API を持ち、ローカル LLM 環境では Ollama や LM Studio がOpenAI 互換 API を提供する。

利用したいモデルは存在するにもかかわらず、API 仕様が違うために接続できない。SDK を書き換え、変換レイヤーを実装し、環境ごとに設定を分ける必要がある。

こうした問題を解決するのが llmglot である。

GitHub: https://github.com/Himeyama/llmglot

llmglot とは

llmglot は、複数の LLM API を相互変換するプロキシサーバーである。

Anthropic Messages API、OpenAI Responses API、OpenAI Chat Completions API、Gemini API などを受け取り、上流の API へ適切に変換して転送する。

つまり、クライアントが要求するAPI仕様と、実際に利用したいモデルのAPI仕様が一致していなくても利用できる。

対応範囲

クライアント側としては、

  • Claude Code
  • Anthropic SDK
  • OpenAI SDK
  • Responses API クライアント
  • Gemini SDK

などに対応している。

接続先としては、

  • Ollama
  • LM Studio
  • OpenAI
  • Gemini
  • OpenRouter
  • Azure OpenAI
  • vLLM

などが利用できる。

例えば、

  • Claude Code → Ollama
  • OpenAI SDK → Gemini
  • Responses API → Chat Completions API

といった接続が可能になる。

Claude Code とローカル LLM を接続する

llmglot の用途の一つが、Claude Code とローカル LLM の接続である。

例えば Ollama を利用している場合、

CHAT_BASE_URL=http://localhost:11434/v1 llmglot

として起動する。

その後、Claude Code の接続先を llmglot へ変更するだけで、Claude Code からローカル LLM を利用できる。

高価なAPIを利用せずにコードエージェントを試せる点は非常に魅力的である。

(補足: Ollama は Messages API に対応しているので実はプロキシは不要である)

Responses API にも対応

近年は Responses API を利用するツールが増えている。

llmglot は /v1/responses エンドポイントを実装しており、HTTP だけでなく WebSocket にも対応している。

そのため、Codex CLI のような Responses API ベースのクライアントとも接続しやすい。

ログ機能が便利

llmglot にはログ表示機能が搭載されている。

確認できる情報は、

  • モデル名
  • プロバイダー
  • 入力トークン数
  • 出力トークン数
  • キャッシュ利用量
  • 推定コスト
  • 生成速度

などである。

複数の LLM を利用する環境では、利用状況を一元管理できるメリットは大きい。

LiteLLM との違い

ここで気になるのが LiteLLM との違いである。

どちらも LLM の間に入るソフトウェアだが、目指している方向は大きく異なる。

LiteLLMの考え方

LiteLLM は多数の LLM プロバイダーを OpenAI 形式に統一する。

つまり、

アプリ

LiteLLM

各LLMプロバイダー

という構成である。

アプリケーション開発者が統一 API を利用するための仕組みと言える。

llmglot の考え方

一方 llmglot は、

Claude Code
Codex CLI
Gemini SDK

llmglot

各 LLM プロバイダー

という構成になる。

クライアント側の API 仕様を変換することが目的である。

Claude Code で比較する

Claude Code は Anthropic Messages API を利用する。

LiteLLM は基本的に OpenAI 互換 API を中心としているため、そのままClaude Code を接続することは難しい。

一方 llmglot は Anthropic Messages API を直接受け付ける。

そのため、

Claude Code

llmglot

Ollama

という構成が実現できる。

これは llmglot の非常に大きな特徴である。

どちらを選ぶべきか

LiteLLM が向いているのは、

  • AI アプリケーションを開発する人
  • OpenAI SDK を統一インターフェースとして利用したい人
  • 負荷分散やフォールバックを行いたい人

である。

一方、llmglot が向いているのは、

  • Claude Code を別のモデルで動かしたい人
  • ローカル LLM を既存クライアントから利用したい人
  • Responses API を別の API へ変換したい人
  • SDK を書き換えたくない人

である。

まとめ

LLM の世界ではモデルそのものよりも API の違いが問題になる場面が増えている。

Claude Code を使いたいが Ollama を利用したい。OpenAI SDK を使いたいが Gemini を利用したい。こうした要求は今後さらに増えていくだろう。

llmglot は、その間に立って API 仕様の違いを吸収する。

  • Claude Code → Ollama
  • OpenAI SDK → Gemini
  • Responses API → Chat Completions API
  • Gemini API → OpenAI互換API

LiteLLM が「開発者向けの統一 API」であるのに対し、llmglot は「クライアント互換プロキシ」と言える。

Coreutils for Windows のまとめ

WinGetでインストールできるMicrosoft公式Linuxコマンド群の最新動向(2026年6月更新)

2026年6月、Microsoftは Coreutils for Windows を正式に公開した。

winget install Microsoft.Coreutils

このコマンドでインストールできる Microsoft.Coreutils は、LinuxやmacOSで日常的に利用される lscprmcat などのUNIX系コマンドを、Windows上でネイティブ実行できるようにするMicrosoft公式プロジェクトである。

本記事では、プロジェクトの概要、対応コマンド、制限事項、WSLやPowerShell との違いを整理する。

概要

Microsoft.Coreutilsは、MicrosoftがメンテナンスするWindows向けのコマンドラインツール群である。

内部的には、

  • uutils/coreutils
  • findutils
  • grep

をベースに構築されており、Rust で実装されている。

Microsoft はこのプロジェクトの目的を、

Linux、macOS、WSL、コンテナ、Windowsを行き来する開発者の摩擦を減らすこと

と説明。

インストール方法

WinGet から簡単に導入可能である。

winget install Microsoft.Coreutils

WinGetはWindows標準のパッケージマネージャーであり、指定したパッケージを自動的にダウンロード・インストール可能。

インストール後は通常のコマンドとして利用可能。

ls
cat file.txt
grep keyword log.txt
cp source.txt backup.txt

利用できる主なコマンド

代表的なコマンドは以下の通り。

分類コマンド例
ファイル一覧ls
ファイルコピーcp
ファイル移動mv
ファイル削除rm
内容表示cat
作業ディレクトリpwd
ディレクトリ作成mkdir
スリープsleep
パイプ処理tee
検索grep, find

Linux利用者であれば見慣れたコマンドがそのまま利用可。

PowerShellとの衝突問題

ここが最大の注意点!

PowerShell には既に同名のエイリアスや組み込みコマンドが存在する。

例:

コマンド問題
lsPowerShellエイリアスと衝突
cpCopy-Itemと衝突
catGet-Contentと衝突
rmRemove-Itemと衝突
pwdGet-Locationと衝突

そのため、

ls

を実行しても、必ずしも Coreutils 版が呼ばれるわけではない。

Microsoft は PowerShell 7.4 以降の利用を推奨している。

Windows特有の制約

Linux 互換を目指しているものの、Windowsの仕組みによる制限が存在する。

1. POSIX シグナルがない

Linuxの

kill
SIGTERM
SIGKILL

の仕組みはWindowsに存在しない。

そのため、

kill
timeout

は現時点で提供されない。

2. /dev/null が存在しない

Linux:

grep error log.txt > /dev/null

Windows:

grep error log.txt > NUL

となる。

3. ACLとPOSIX権限の違い

Windows は ACL ベースの権限管理である。

そのため、

chmod
chown
chgrp

などのコマンドは提供されない。


4. シンボリックリンク作成

読み取りは可能だが、新規作成には

  • Developer Mode
  • 管理者権限

が必要である。

提供されない主なコマンド

Microsoft は一部コマンドを意図的に除外している。

Windows と衝突するもの

  • dir
  • more
  • paste
  • whoami
  • expand

POSIX 依存が強いもの

  • chmod
  • chown
  • chgrp
  • chroot
  • nohup
  • stty
  • tty
  • who

現時点で未実装なもの

  • kill
  • timeout
  • dd

WSLとの違い

よく比較されるのが WSL(Windows Subsystem for Linux)である。

項目Microsoft.CoreutilsWSL
導入コスト非常に低いLinux環境構築が必要
起動速度ネイティブ仮想環境層あり
Linux互換性一部非常に高い
Bash環境なしあり
apt利用不可可能
シェルスクリプト互換性限定的高い

WSL は「Linux 環境そのもの」だが、Coreutils は「Windows 上で Linux 風コマンドを使うためのツール集」である。

Makefile のすすめ

背景と課題意識

日々の業務で Python スクリプトを用いてデータ変換の自動化を行うと、次のような課題に直面することが多い。

  • 元データの一部だけが更新されたのに全体を実行し直して時間を浪費する。
  • どの手順がどのファイルに依存しているかが曖昧で、実行順序や抜け漏れの管理が難しい。
  • スクリプトの変更がどの成果物に影響するか掴みにくい。

Makefile は「依存関係」と「差分だけの再実行(インクリメンタルビルド)」を標準機能として備え、これらの課題を小さな記述で解決できる道具である。

Make の基本

  • ターゲット: 生成物(例: output/report.csv)
  • 依存関係: 生成に必要なファイル(例: data/clean/*.csv やスクリプト)
  • レシピ: 生成に使うコマンド(例: python scripts/aggregate.py ...)

Make は「依存関係がターゲットより新しいときにだけレシピを実行」する。これにより、元データや Python スクリプトを更新した場合に、必要な箇所のみが自動的に再実行される。

最小構成の Makefile 例

以下は raw データをクリーニングし、集計レポートを作る一連の処理を差分実行する例である。

# Makefile
SHELL := bash
.SHELLFLAGS := -eu -o pipefail -c
.DELETE_ON_ERROR:
.ONESHELL:
.DEFAULT_GOAL := all

RAW_DIR := data/raw
CLEAN_DIR := data/clean
OUT_DIR := output

RAW := $(wildcard $(RAW_DIR)/*.csv)
CLEAN := $(patsubst $(RAW_DIR)/%.csv,$(CLEAN_DIR)/%.csv,$(RAW))
REPORT := $(OUT_DIR)/report.csv

# ディレクトリは順序限定依存(存在しなければ作るが、更新判定には使わない)
$(CLEAN_DIR) $(OUT_DIR):
mkdir -p $@

# 集計レポートはクリーン済み CSV と集計スクリプトに依存
$(REPORT): $(CLEAN) scripts/aggregate.py | $(OUT_DIR)
python scripts/aggregate.py -i $(CLEAN_DIR) -o $@

# 各 raw CSV から対応する clean CSV を生成
$(CLEAN_DIR)/%.csv: $(RAW_DIR)/%.csv scripts/clean.py | $(CLEAN_DIR)
python scripts/clean.py -i $< -o $@

.PHONY: all clean status

all: $(REPORT)

clean:
rm -rf $(CLEAN_DIR) $(OUT_DIR)

# 何が再ビルド対象かを確認するヘルパ
status:
@echo "RAW : $(RAW)"
@echo "CLEAN : $(CLEAN)"
@echo "REPORT: $(REPORT)"
@echo
@echo "Dry-run (what would run):"
@$(MAKE) -n all

この構成により次が実現できる。

  • 元データ data/raw/foo.csv を更新すると、対応する data/clean/foo.csv だけが再生成される。
  • scripts/clean.py を更新すると、クリーン工程だけが必要分再実行される。
  • scripts/aggregate.py を更新すると、集計レポートだけが再実行される。

動作イメージ

# 初回(すべて生成)
make -j

# 一部の raw が更新(そのファイルのクリーンとレポートのみ再実行)
touch data/raw/a.csv
make -j

# クリーニングスクリプトが更新(全クリーンとレポートを再実行)
touch scripts/clean.py
make -j

# 集計スクリプトが更新(レポートのみ再実行)
touch scripts/aggregate.py
make

「何が走るか」を事前確認するには make -n が有効である。

スクリプト依存の設計指針

  • 各ルールには、それを直接呼び出す Python スクリプトを依存関係として明示することが重要である。
  • 複数のモジュールに分割している場合、対象ルールが import するモジュールまで依存に含めると変更が正しく伝播する。簡便策としては対象ディレクトリの Python ファイル一式を変数化して依存に加える。

例(簡便策):

PY_SRCS := $(wildcard scripts/**/*.py) $(wildcard scripts/*.py)

$(CLEAN_DIR)/%.csv: $(RAW_DIR)/%.csv $(PY_SRCS) | $(CLEAN_DIR)
python scripts/clean.py -i $< -o $@

並列実行と高速化

  • make -j により独立したファイル変換を並列化できる。データ点数が多いほど効果が高い。
  • 中間生成物を細かく分割するほど差分実行が効きやすく、全体の再計算を回避できる。
  • I/O がボトルネックの場合は圧縮形式やファイル分割、ローカル SSD などと併用する。

実運用のコツ

  • ディレクトリ作成は順序限定依存(| dir)で扱い、無駄な再ビルドを避ける。
  • 失敗時に不完全な生成物を残さないために .DELETE_ON_ERROR を有効化する。
  • よく使う入口を .DEFAULT_GOAL := all で標準化し、make 一発で動かせるようにする。
  • デバッグには make -n(実行せず表示)、make --trace(どの判定で動くか表示)、make -d(詳細ログ)を使う。
  • クリーンアップは .PHONY: clean とし、生成物だけを削除するよう注意する。

仮想環境と依存パッケージ(任意)

Python の実行環境も Make で管理できる。

VENV := .venv
PY := $(VENV)/bin/python

$(VENV)/bin/python: requirements.txt
python3 -m venv $(VENV)
$(VENV)/bin/pip install -r requirements.txt
touch $@

# 以降のレシピで $(PY) を使う
$(CLEAN_DIR)/%.csv: $(RAW_DIR)/%.csv scripts/clean.py | $(CLEAN_DIR) $(VENV)/bin/python
$(PY) scripts/clean.py -i $< -o $@

$(REPORT): $(CLEAN) scripts/aggregate.py | $(OUT_DIR) $(VENV)/bin/python
$(PY) scripts/aggregate.py -i $(CLEAN_DIR) -o $@

requirements.txt を更新すると必要な範囲でのみ再セットアップされる。

まとめ

  • Makefile は「依存関係の明示」と「差分だけの再実行」を自動化し、データ変換パイプラインの信頼性と開発速度を大きく向上させる道具である。
  • 元データ、スクリプト、生成物を正しく結び、処理を細かく分割することで、更新の影響範囲だけが素早く再計算される。
  • 最小の記述で再現性・並列化・可観測性が手に入り、日々の自動化作業が一段と快適になるのである。

Cloudflare Workers で独自ドメインをさくらサーバーのサブパスに割り当てた

背景

さくらのレンタルサーバー「ライトプラン」は、36ヶ月一括払いで 月額121円 という破格の安さだ。(12ヶ月一括の場合は月165円) 静的ファイルのホスティングや CGI 用途としては十分で、個人用途のストレージとして気軽に使える。

ただし、割り当てられるドメインは ユーザー名.sakura.ne.jp のサブドメインになるため、 独自ドメインで特定のパスに紐づけたい場合は一工夫が必要になる。

やりたいこと

https://app.example.com にアクセスすると、 https://sakurauser.sakura.ne.jp/app/ のコンテンツが URL を変えずに 表示されるようにする。

なぜ単純な DNS 設定ではできないのか

DNS の CNAME レコードはホスト名しか指定できず、 /app/ のような パスを含む URL は指定できない

リダイレクト (301) でも実現できるが、 ブラウザのアドレスバーの URL が sakurauser.sakura.ne.jp/flower/ に変わってしまう。

Cloudflare Workers を使った透過プロキシなら、 URL を app.example.com のまま維持できる。

前提条件

  • Cloudflare に独自ドメイン (例: example.com) を登録済みであること
  • Cloudflare の無料プランで OK (10万リクエスト/日まで無料)

手順

1. Worker を作成する

  1. Cloudflare ダッシュボード → Workers & PagesCreate
  2. Start with Hello World! を選択
  3. Worker 名を入力 (例: storage-proxy)
  4. Deploy をクリック

2. コードを編集する

Deploy 後、Edit code をクリックし、 以下のコードに全て置き換える

export default {
async fetch(request) {
const url = new URL(request.url);
const target = new URL("https://sakurauser.sakura.ne.jp");
target.pathname = "/app" + url.pathname;
target.search = url.search;

const newRequest = new Request(target.toString(), {
method: request.method,
headers: request.headers,
body: request.body,
});

const response = await fetch(newRequest);

const newHeaders = new Headers(response.headers);
newHeaders.delete("content-security-policy");
newHeaders.delete("x-frame-options");

return new Response(response.body, {
status: response.status,
headers: newHeaders,
});
}
};

まとめ

  • さくらのレンタルサーバー ライトプランは 月額121円 と格安で、静的ファイルの置き場として十分使える
  • ただし独自ドメインをサブパスに割り当てる DNS 設定は標準機能では不可能
  • Cloudflare Workers を透過プロキシとして挟むことで、URL を変えずにコンテンツを配信できる
  • Workers のコードは数十行で済み、Cloudflare 無料プランの範囲内で動作する