「LLM」タグの記事が4件件あります
全てのタグを見るWindows 11 で llama.cpp をビルドして動かすまで
ローカル LLM 推論エンジンの定番である llama.cpp を、Windows 11 環境で NVIDIA GPU の CUDA バックエンドを有効にしてソースからビルドし、実際にモデルを動かすところまでの記録。
【2026年7月】生成 AI モデルを比較 (Claude, GPT, Gemini, Grok, DeepSeek, Kimi, GLM, Mistral)
OpenRouter は、Claude、GPT、Gemini といったクローズドなモデルや中国発の オープンウェイトモデルまで、いろんなAIを切り替えて使える。とはいえ「結局どれを選べばいいのか」 と悩みがちなので、今回は主要モデルの値段と実力をざっくり比較してみた。
そもそも「オープン」と「クローズド」とは
- クローズド: Claude・GPT・Gemini・Grok のように、モデルの中身(重み)が公開されていないもの。 会社のサーバー経由でしか使えない。
- オープンウェイト: DeepSeek・Kimi・GLM・Mistral のように、モデルの中身が公開されていて、 誰でも自分のPCやクラウドで動かせるもの。
階級別の値段
まずは最重量の値段から。
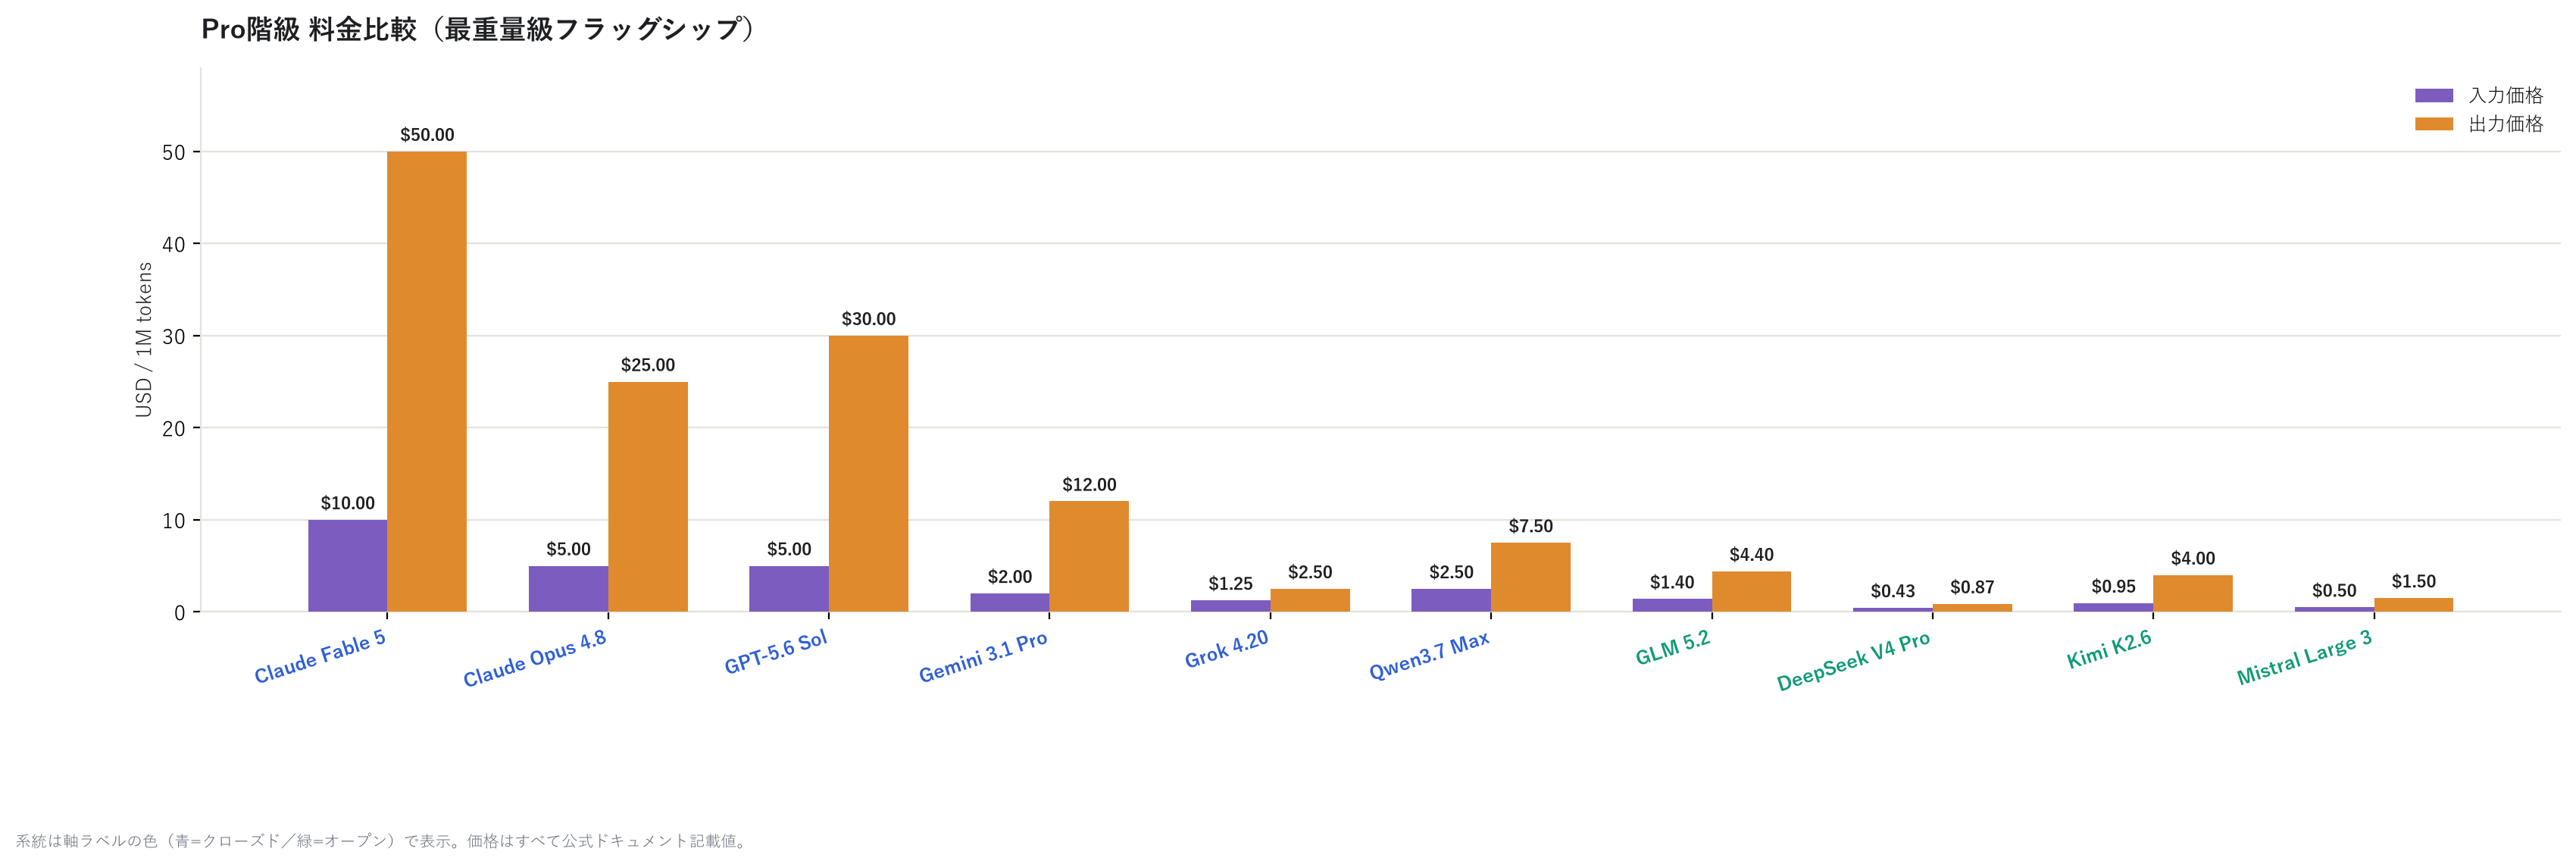
見ての通り、Claude Fable 5 が圧倒的に高い(出力 $50/1Mトークン)一方、DeepSeek V4 Pro は 出力たったの $0.87。同じ「Pro」を名乗っていても、値段の差は50倍以上ある。オープン勢 (緑色のラベル)が軒並み安いのが一目瞭然だ。
中小量級も見てみる。
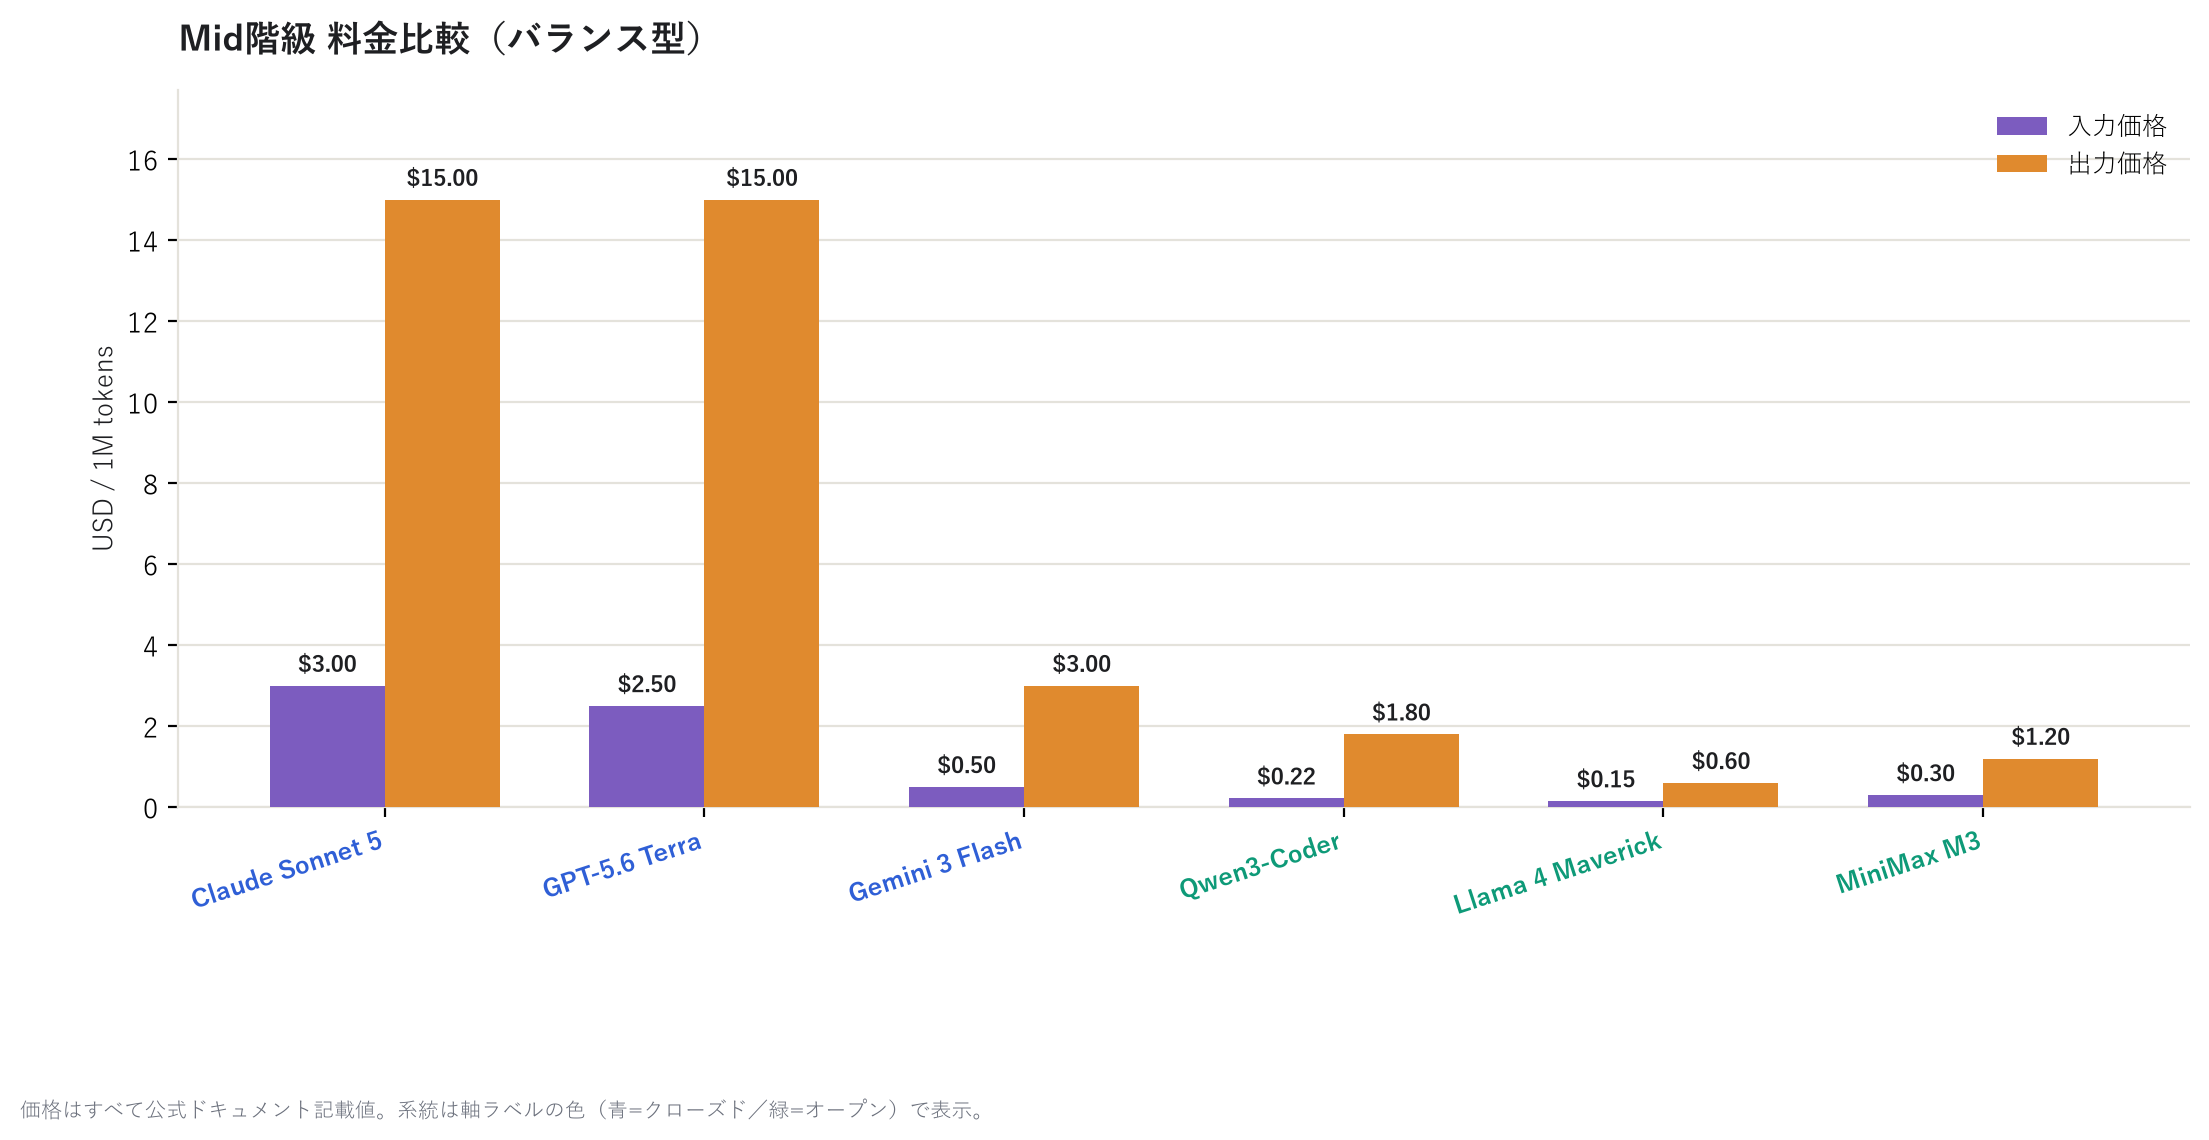
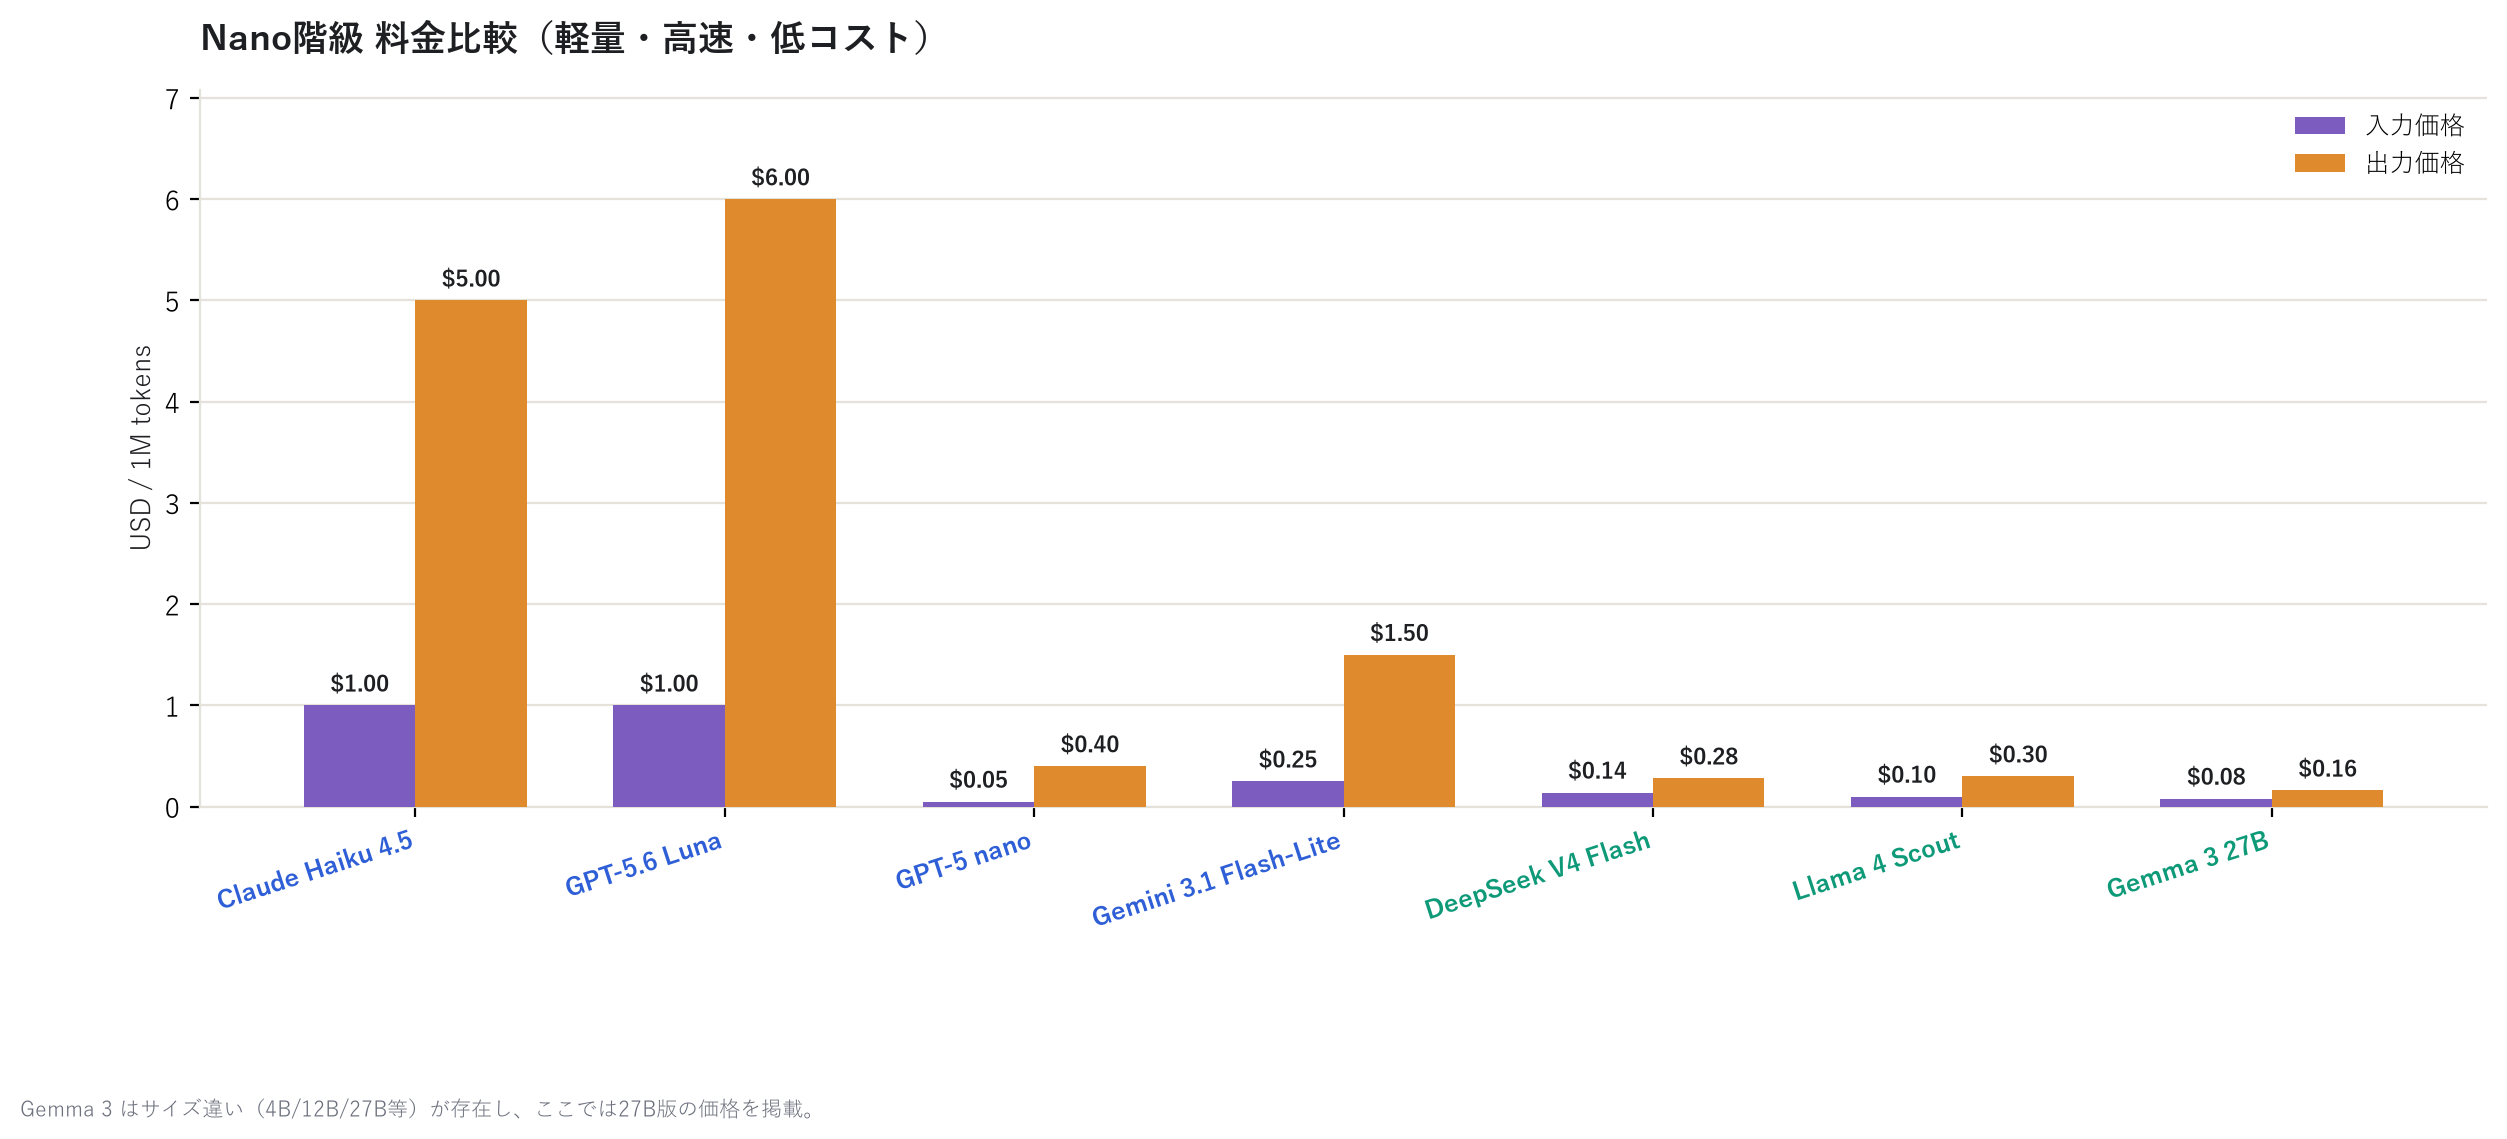
小量級になると、GPT-5 nano は出力 $0.40 とほぼ「使い放題」レベルの安さだ。ちょっとした 分類作業や下書き生成なら、この階級で十分なことも多い。
コスパを見てみる
値段だけ見ると「安いモデルは性能も低いのでは」と思いがちだが、実はそうでもない。 階級を分けずに、価格とIntelligence Indexのスコアがそろっているモデル20個を1枚にまとめてみる。 GPT・Gemini・Qwen・Llama・Gemma・Mistralなど、オープン/クローズド問わずできるだけ多くの モデルを含めた。
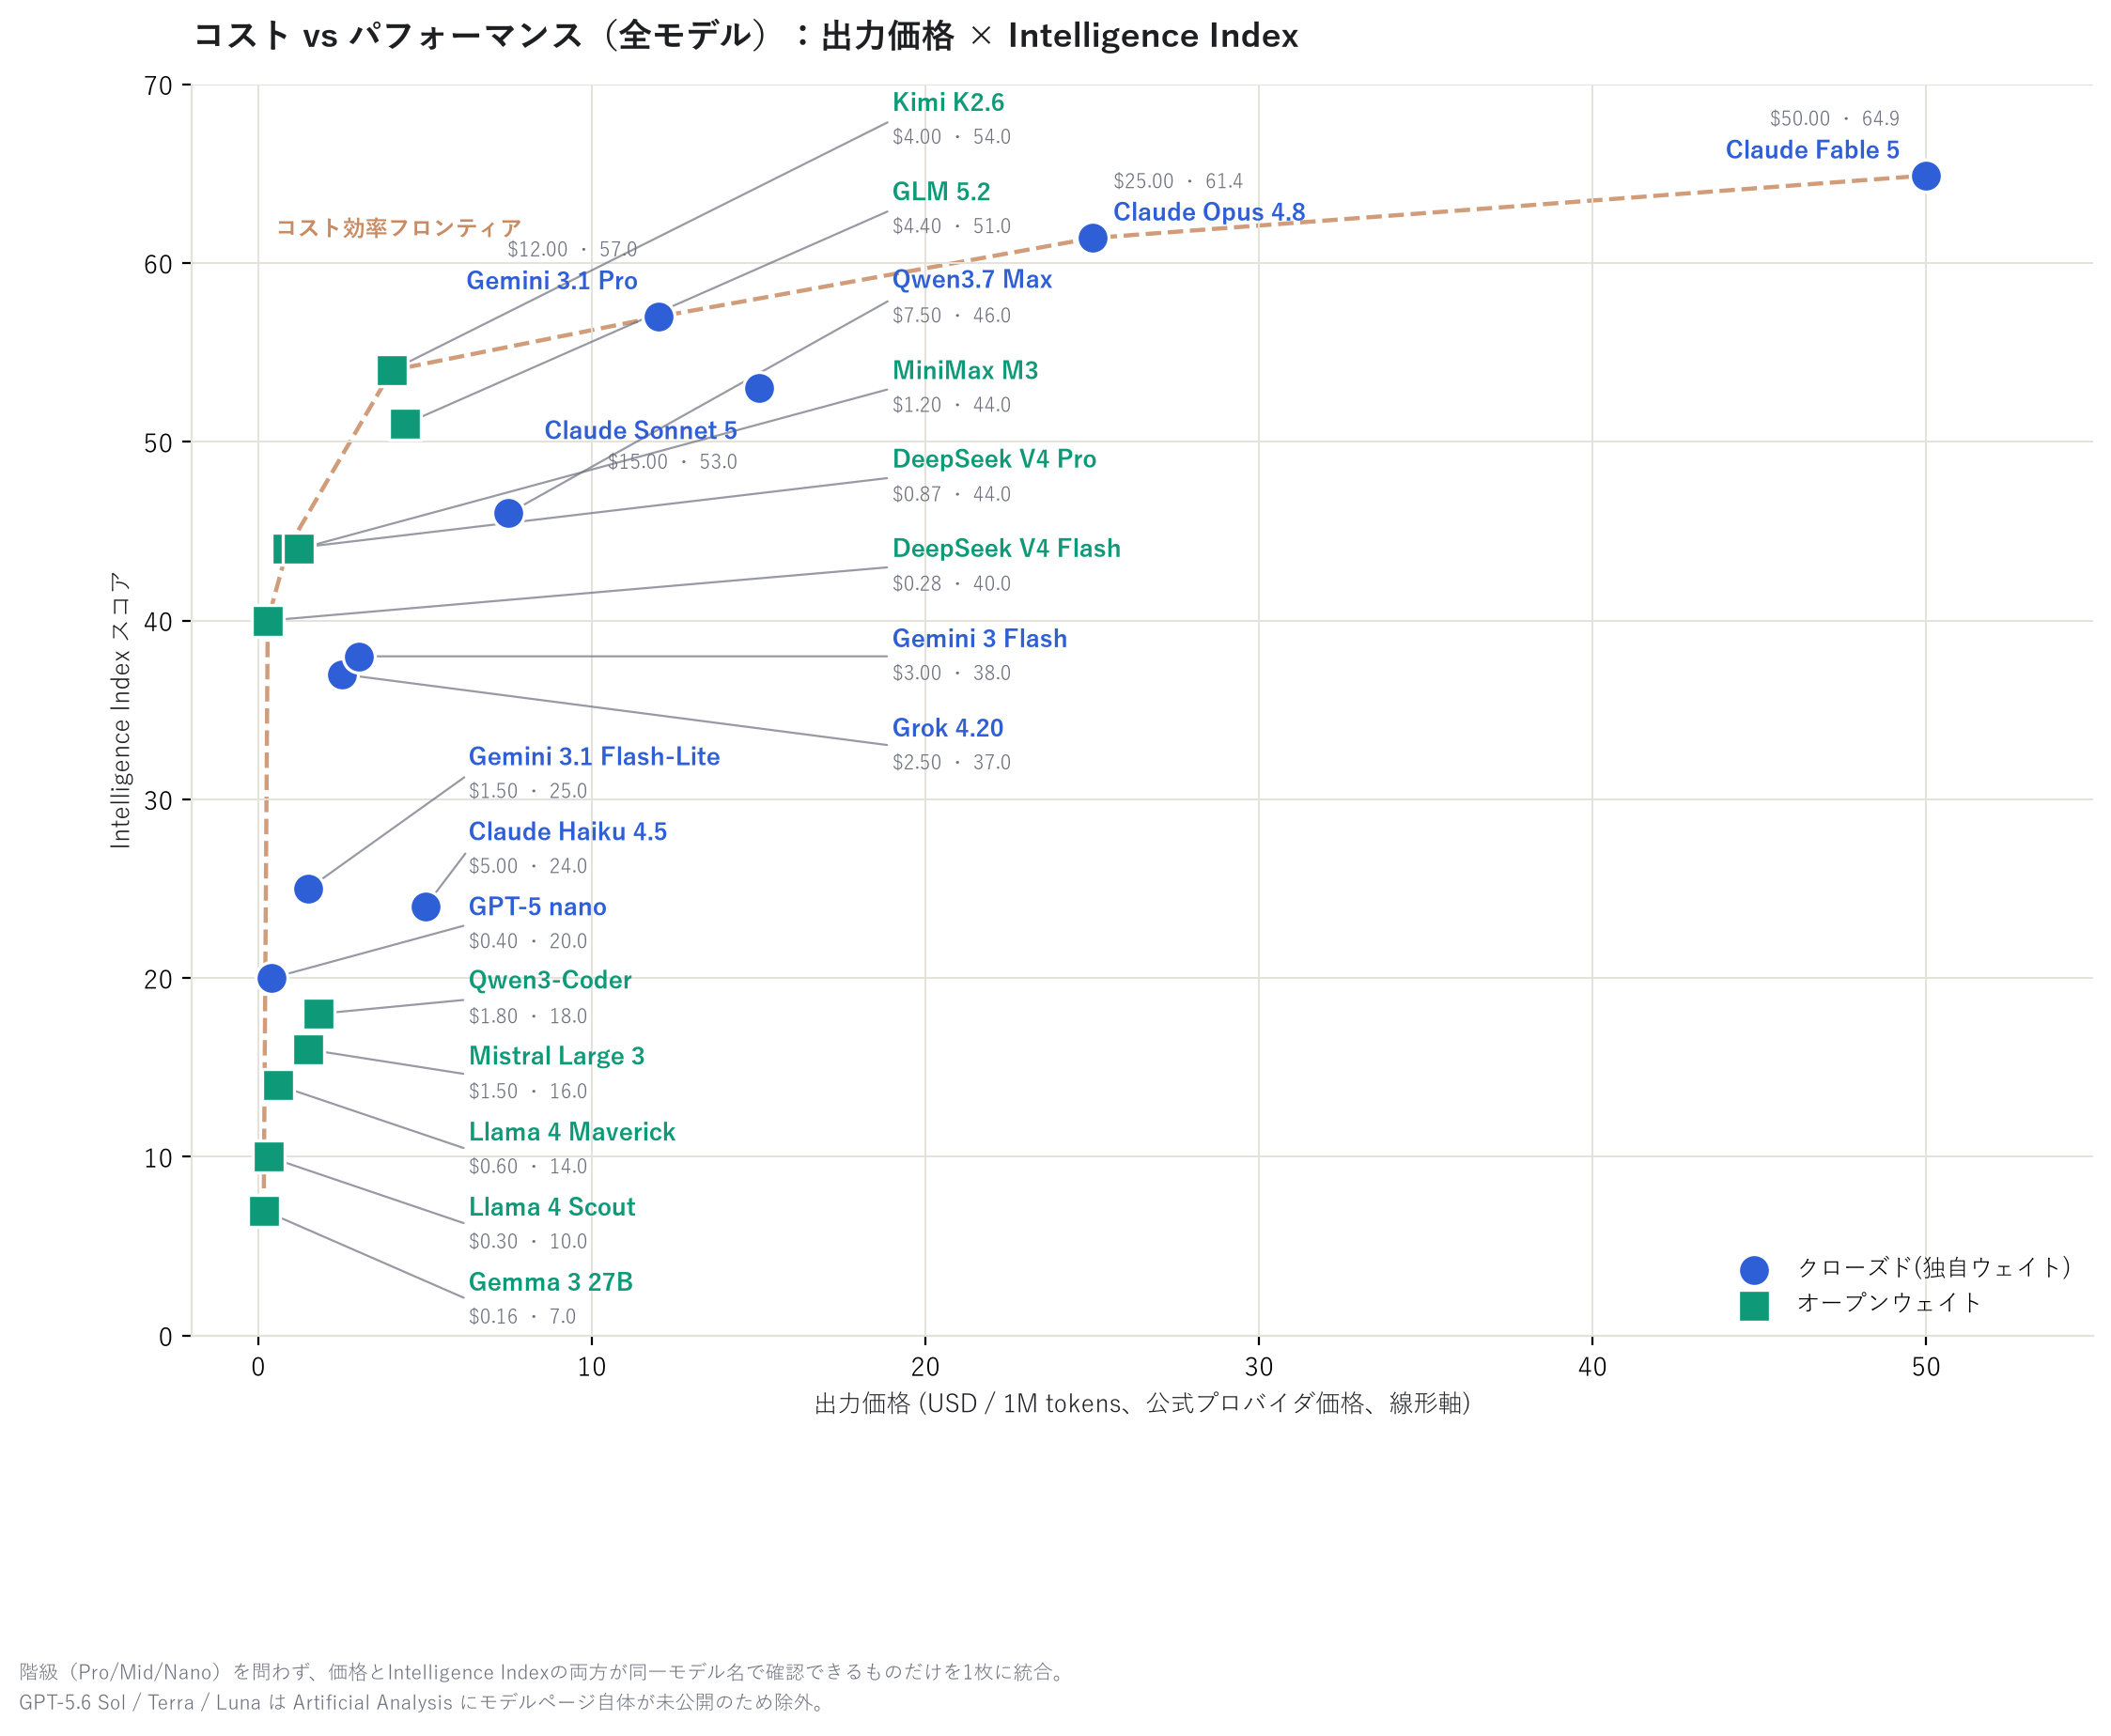
縦軸は「Intelligence Index」という総合力スコア(詳しくは後述)。点線で結んだ「コスパの良い ライン」は Gemma 3 27B → DeepSeek V4 Flash → DeepSeek V4 Pro → Kimi K2.6 → Gemini 3.1 Pro → Claude Opus 4.8 → Claude Fable 5 という、Nano・Mid・Proの階級をまたいだ 7モデルで形成されている。DeepSeek V4 Pro はわずか出力$0.87でGemini 3.1 Pro($12.00)に迫る スコアを出しており、実質的なコスパの起点として頭ひとつ抜けている。一方、フロンティアの内側に ある Qwen3.7 Max・MiniMax M3・GLM 5.2・Claude Sonnet 5・Gemini 3 Flash・Grok 4.20・ Claude Haiku 4.5・Gemini 3.1 Flash-Lite・Qwen3-Coder・Mistral Large 3・Llama 4 Maverick・ Llama 4 Scout などは「同じくらいの価格帯の他モデルより実力で見劣りする」ポジションだ。
コスパ重視なら、まずは一番安いところから試してみるのもアリだろう。
結局どのモデルが一番賢いのか
総合力とコーディング力のランキングも見てみる。
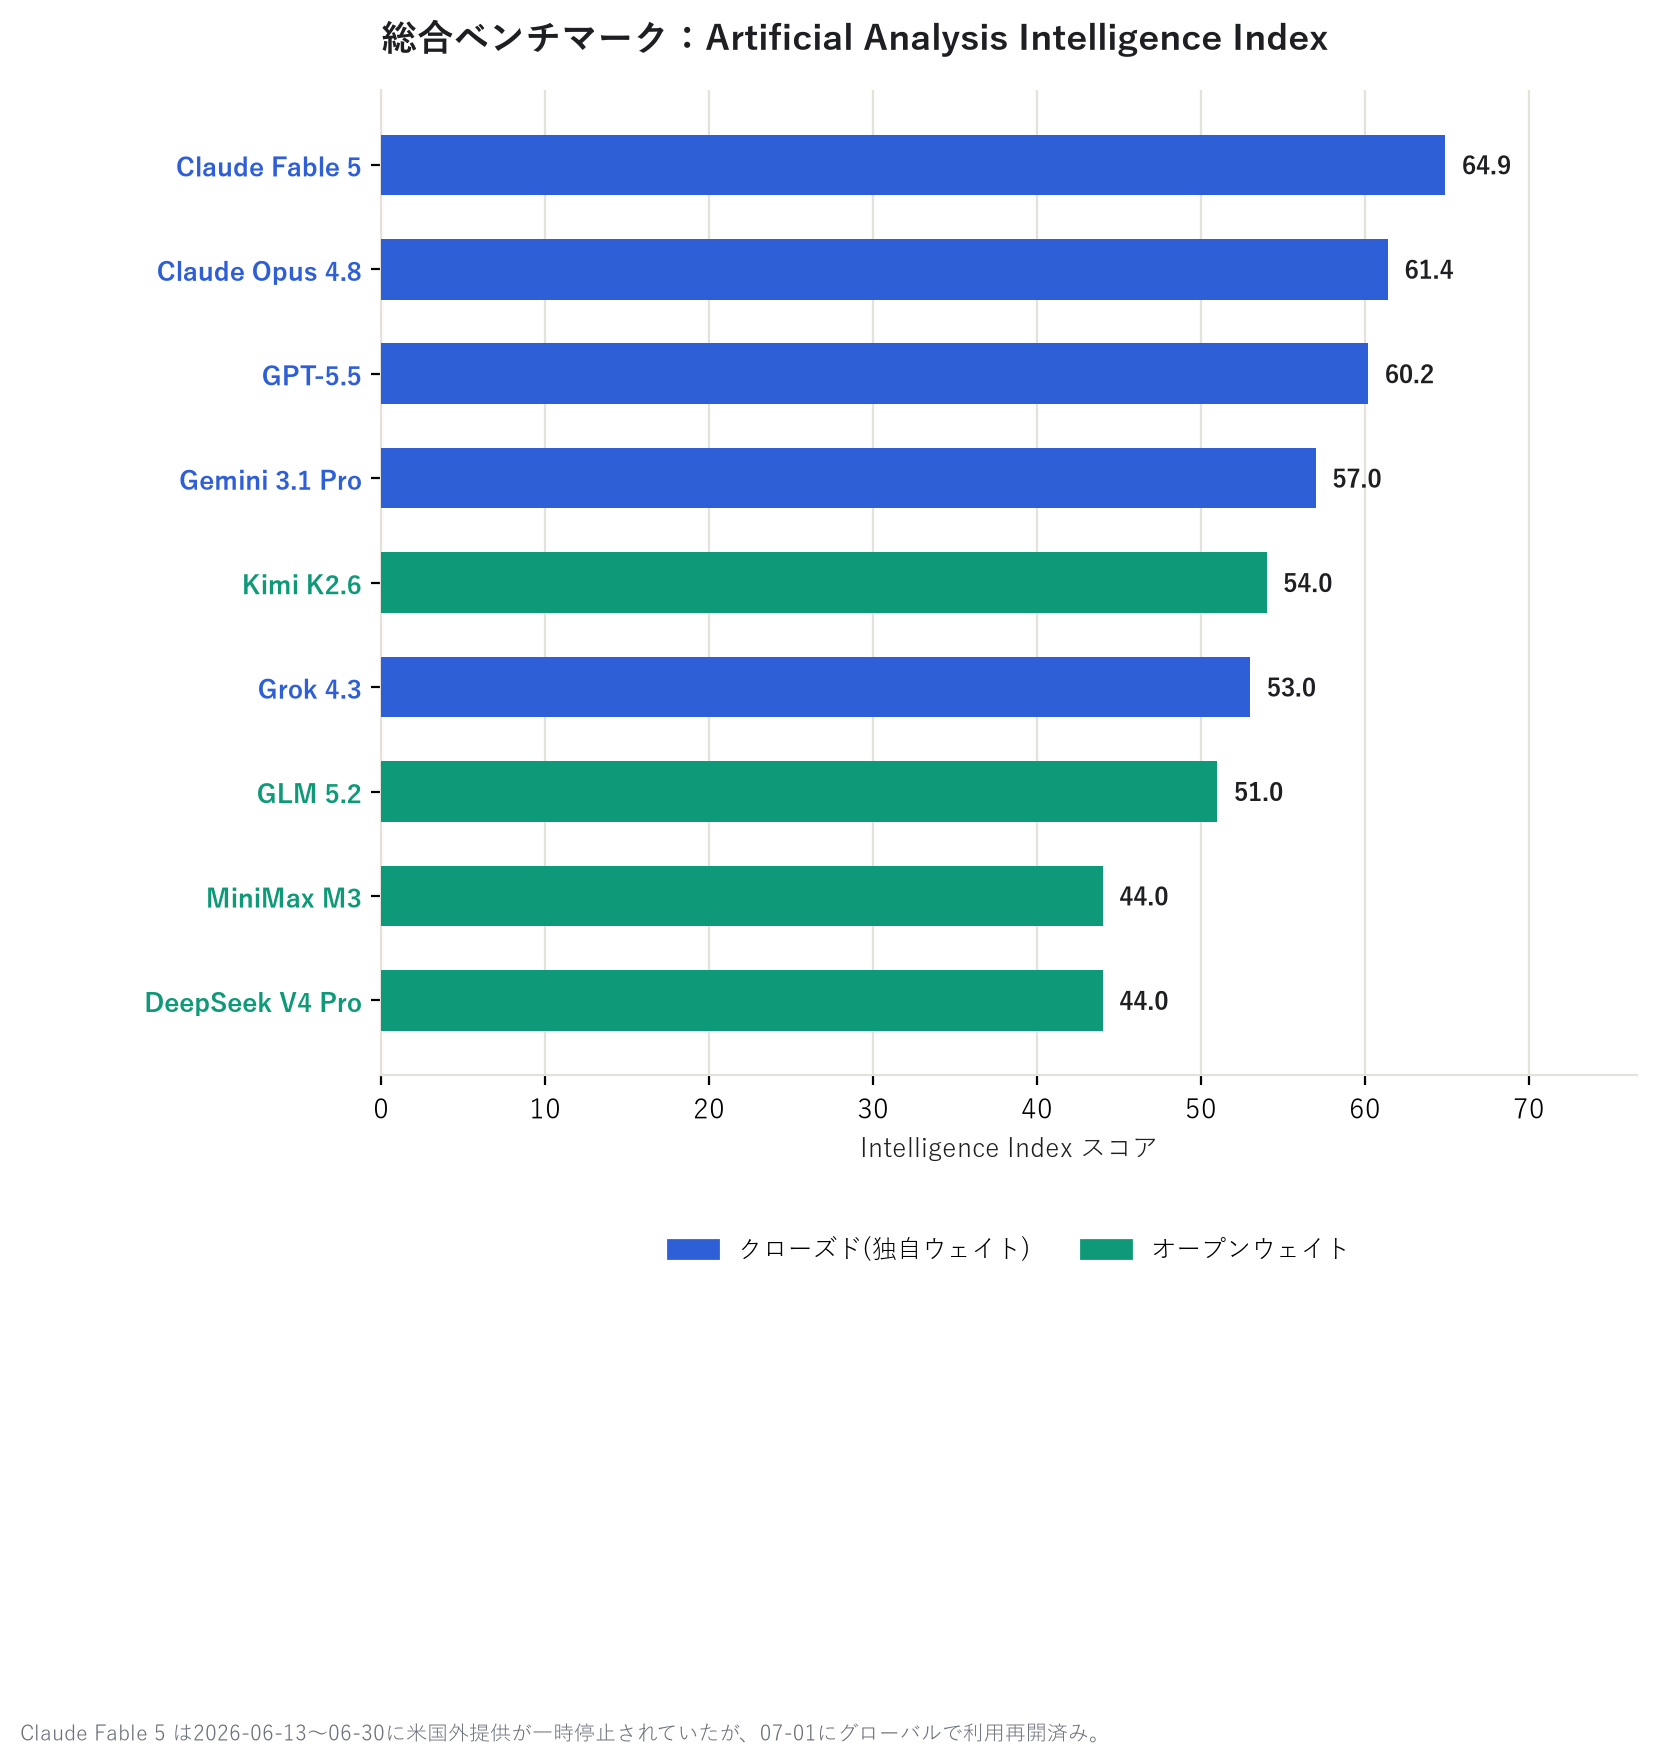
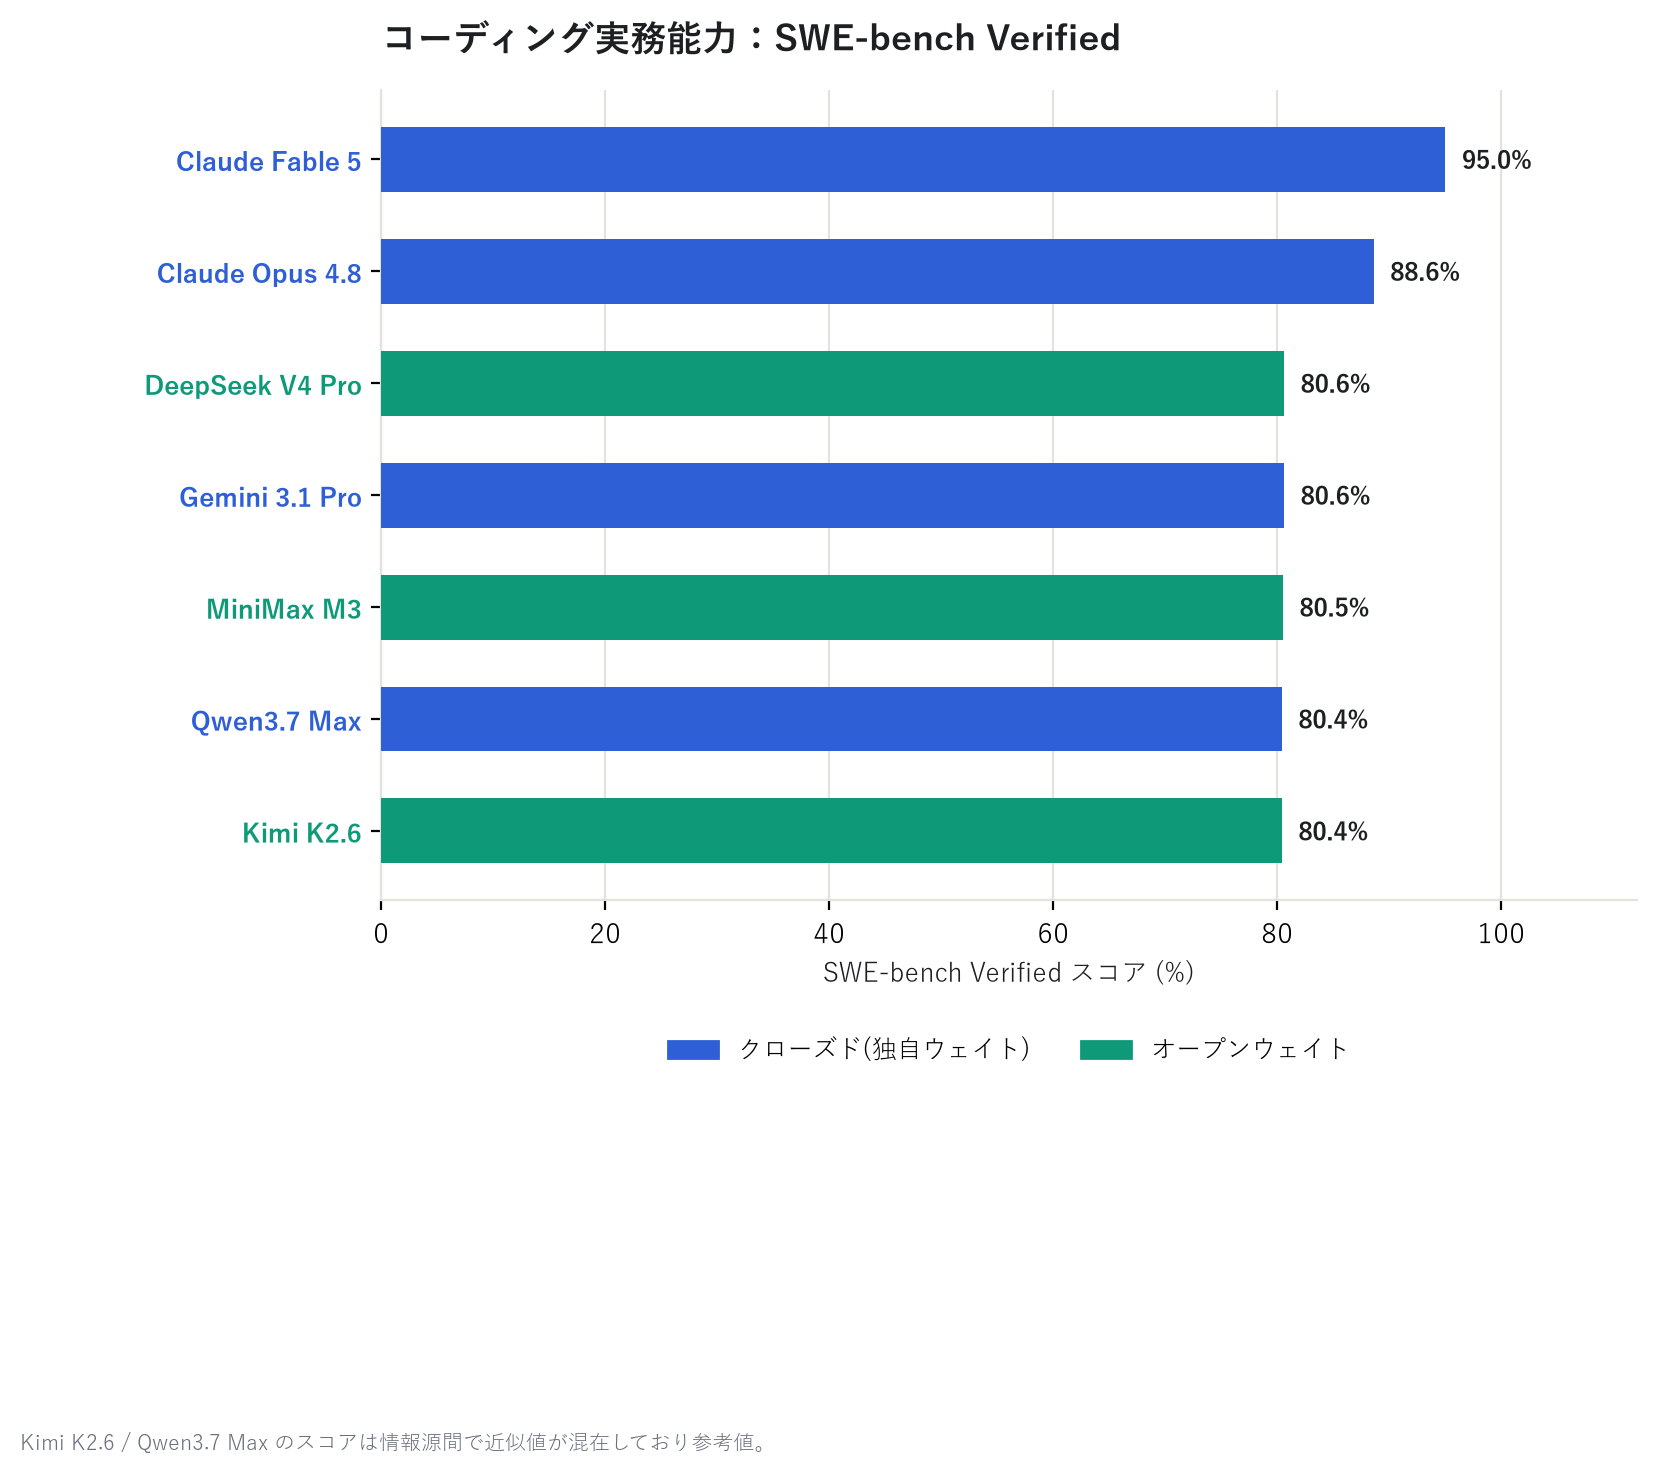
1枚目の「総合力」は Artificial Analysis Intelligence Index という第三者ベンチマーク団体の スコア、2枚目の「コーディング力」は SWE-bench Verified という、実在するソフトウェアの バグ修正課題をどれだけ解けるかを測るテストのスコアだ。どちらも各モデル会社の自己申告ではなく、 外部の評価サイトが計測・公表している数値である。
総合力では Claude Fable 5 がGPT-5.5に約5ポイント差をつけてトップ、僅差で Claude Opus 4.8・ GPT-5.5・Gemini 3.1 Pro が続く。コーディングに限っても Claude Fable 5 が頭ひとつ抜けて95% というスコアだ。そのすぐ下に、オープン系の DeepSeek V4 Pro がクローズド勢と肩を並べているのも 面白いポイントである。
おまけ:オープンモデルの「中身の大きさ」
オープンウェイトモデルは中身が公開されているので、パラメータ数(モデルの大きさ)も分かる。 バーの濃い緑が実際に推論で使われる「活性化パラメータ」、薄い緑がMoE(Mixture of Experts)構成上 その時使われていない残りのエキスパート分だ。
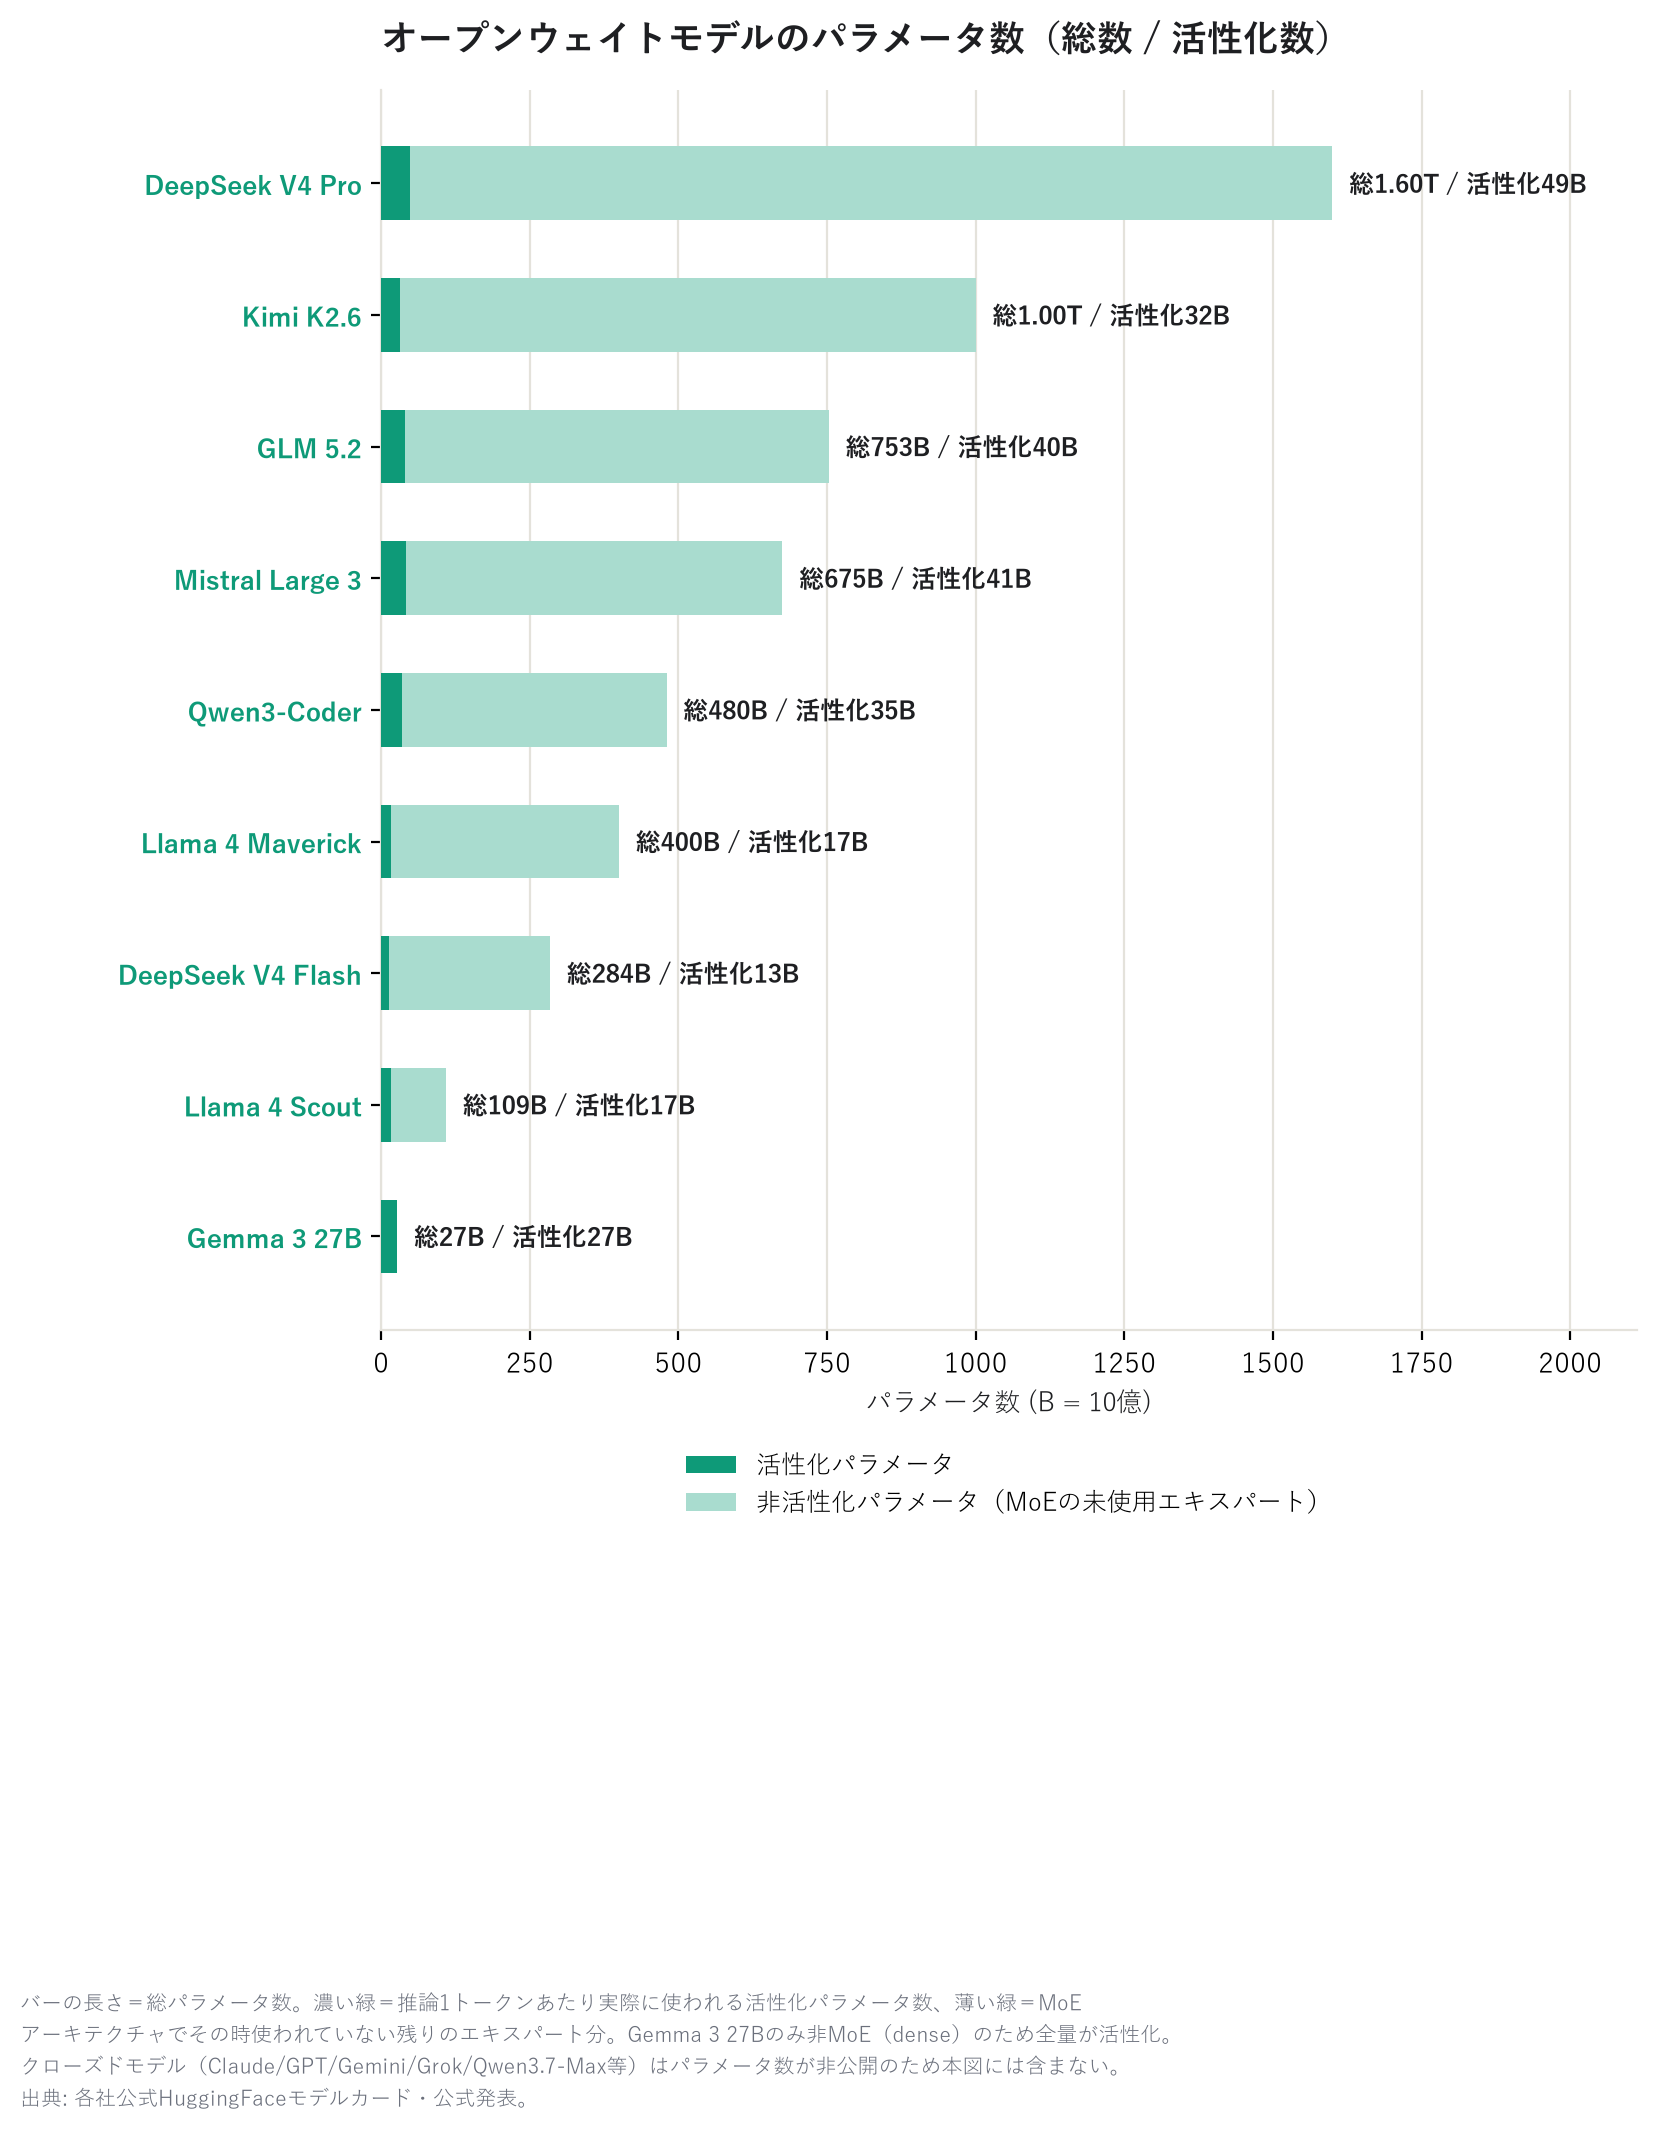
DeepSeek V4 Pro が総1.6兆パラメータで一番大きいが、実際に動くときに使うのは そのうち490億だけ(MoEという仕組みのおかげ)。大きい割に軽快に動く、というのがポイントだ。 図中で唯一 Gemma 3 27Bだけはバーが全部濃い緑になっているが、これはMoEではなく 全パラメータを毎回使う「dense」構成だから。デンスモデルは総数=活性化数になるため、 MoE勢とは大きさの比較の意味合いが少し異なる点に注意。
まとめ:どれを選べばいいか
- とにかく一番賢いのが欲しい → Claude Fable 5 か Claude Opus 4.8(値段は覚悟)
- コスパ重視、コーディングもさせたい → DeepSeek V4 Pro(激安なのにかなり優秀)
- 普段使いのバランス型 → Claude Sonnet 5 や Gemini 3 Flash
- とにかく安く大量にさばきたい → GPT-5 nano や DeepSeek V4 Flash
値段もランキングも動きが早い世界なので、実際に使う前には openrouter.ai/models で最新情報を確認することを忘れずに。
スコアの情報元
本記事で使ったベンチマークスコアの出典は以下の通り。いずれもモデル提供元とは独立した 第三者の評価サイトが計測・公表している数値である。
- 総合力(Intelligence Index): Artificial Analysis
- コーディング力(SWE-bench Verified): SWE-bench Leaderboards(公式)
なお Kimi K2.6 / Qwen3.7 Max の SWE-bench Verified スコアは、情報源間で近似値が混在しており 参考値として扱っている。
Claude Code も Codex も Gemini もつなぐ、LLM API 変換プロキシ「llmglot」を開発した
AI 開発の現場では、モデルそのものよりも API 仕様の違いに悩まされることが増えている。
Claude Code は Anthropic Messages API を利用する。OpenAI 系ツールは Chat Completions API や Responses API を利用する。Gemini は独自 API を持ち、ローカル LLM 環境では Ollama や LM Studio がOpenAI 互換 API を提供する。
利用したいモデルは存在するにもかかわらず、API 仕様が違うために接続できない。SDK を書き換え、変換レイヤーを実装し、環境ごとに設定を分ける必要がある。
こうした問題を解決するのが llmglot である。
GitHub: https://github.com/Himeyama/llmglot
llmglot とは
llmglot は、複数の LLM API を相互変換するプロキシサーバーである。
Anthropic Messages API、OpenAI Responses API、OpenAI Chat Completions API、Gemini API などを受け取り、上流の API へ適切に変換して転送する。
つまり、クライアントが要求するAPI仕様と、実際に利用したいモデルのAPI仕様が一致していなくても利用できる。
対応範囲
クライアント側としては、
- Claude Code
- Anthropic SDK
- OpenAI SDK
- Responses API クライアント
- Gemini SDK
などに対応している。
接続先としては、
- Ollama
- LM Studio
- OpenAI
- Gemini
- OpenRouter
- Azure OpenAI
- vLLM
などが利用できる。
例えば、
- Claude Code → Ollama
- OpenAI SDK → Gemini
- Responses API → Chat Completions API
といった接続が可能になる。
Claude Code とローカル LLM を接続する
llmglot の用途の一つが、Claude Code とローカル LLM の接続である。
例えば Ollama を利用している場合、
CHAT_BASE_URL=http://localhost:11434/v1 llmglot
として起動する。
その後、Claude Code の接続先を llmglot へ変更するだけで、Claude Code からローカル LLM を利用できる。
高価なAPIを利用せずにコードエージェントを試せる点は非常に魅力的である。
(補足: Ollama は Messages API に対応しているので実はプロキシは不要である)
Responses API にも対応
近年は Responses API を利用するツールが増えている。
llmglot は /v1/responses エンドポイントを実装しており、HTTP だけでなく WebSocket にも対応している。
そのため、Codex CLI のような Responses API ベースのクライアントとも接続しやすい。
ログ機能が便利
llmglot にはログ表示機能が搭載されている。
確認できる情報は、
- モデル名
- プロバイダー
- 入力トークン数
- 出力トークン数
- キャッシュ利用量
- 推定コスト
- 生成速度
などである。
複数の LLM を利用する環境では、利用状況を一元管理できるメリットは大きい。
LiteLLM との違い
ここで気になるのが LiteLLM との違いである。
どちらも LLM の間に入るソフトウェアだが、目指している方向は大きく異なる。
LiteLLMの考え方
LiteLLM は多数の LLM プロバイダーを OpenAI 形式に統一する。
つまり、
アプリ
    ↓
LiteLLM
    ↓
各LLMプロバイダー
という構成である。
アプリケーション開発者が統一 API を利用するための仕組みと言える。
llmglot の考え方
一方 llmglot は、
Claude Code
Codex CLI
Gemini SDK
       ↓
     llmglot
       ↓
各 LLM プロバイダー
という構成になる。
クライアント側の API 仕様を変換することが目的である。
Claude Code で比較する
Claude Code は Anthropic Messages API を利用する。
LiteLLM は基本的に OpenAI 互換 API を中心としているため、そのままClaude Code を接続することは難しい。
一方 llmglot は Anthropic Messages API を直接受け付ける。
そのため、
Claude Code
    ↓
llmglot
    ↓
Ollama
という構成が実現できる。
これは llmglot の非常に大きな特徴である。
どちらを選ぶべきか
LiteLLM が向いているのは、
- AI アプリケーションを開発する人
- OpenAI SDK を統一インターフェースとして利用したい人
- 負荷分散やフォールバックを行いたい人
である。
一方、llmglot が向いているのは、
- Claude Code を別のモデルで動かしたい人
- ローカル LLM を既存クライアントから利用したい人
- Responses API を別の API へ変換したい人
- SDK を書き換えたくない人
である。
まとめ
LLM の世界ではモデルそのものよりも API の違いが問題になる場面が増えている。
Claude Code を使いたいが Ollama を利用したい。OpenAI SDK を使いたいが Gemini を利用したい。こうした要求は今後さらに増えていくだろう。
llmglot は、その間に立って API 仕様の違いを吸収する。
- Claude Code → Ollama
- OpenAI SDK → Gemini
- Responses API → Chat Completions API
- Gemini API → OpenAI互換API
LiteLLM が「開発者向けの統一 API」であるのに対し、llmglot は「クライアント互換プロキシ」と言える。